
GPT-6基准评分争议,双方均未回应
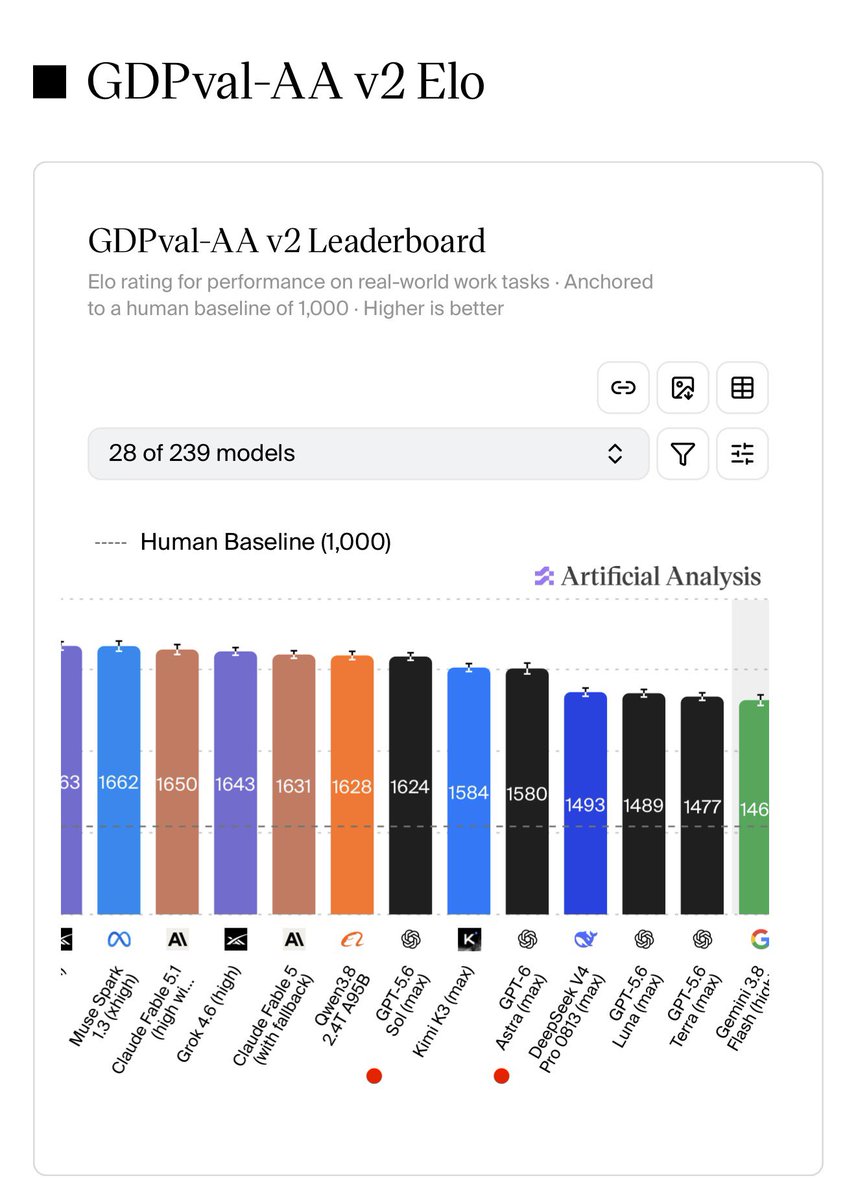
有一件事至今仍让我困惑:Artificial Intelligence Analysis 坚定地维护他们的评分结果,即在 GDPval-AA v2 的真实世界任务中,GPT-6 得分低于 Kimi K3。
我现在每天都在等 OpenAI 或者 Artificial Intelligence Analysis 站出来说,这个评分因为X、Y、Z因素错了。
奇怪的是 OpenAI 对此保持沉默,尤其是在他们刚刚宣布 AGI 之后。难道对于为什么模型在这些任务上可能出现退步,就没有任何解释吗?
最合理的解释之一会不会是,测试对 GPT-6 答案的评判本身就是错的?另一种我从 OpenAI 员工那里听到过、针对之前基准测试的解释是,模型其实答对了问题,但基准测试的组织者没有考虑到某些其实更准确的解读。
现在所有 YouTube 博主说“这不是 AGI”,基本都是拿这个点说事,说模型在这些基准测试上退步了,还声称 OpenAI 在其他领域“benchmaxed”(应该是打错字,benchmarked,指刷榜),这可能是真的。
但就我们掌握的很多私有题目和其他私有基准测试来看,GPT-6 在通用推理上明显要好得多。这就是为什么这件事一直吸引着我,两家公司都没有真正给出解释。
我就在等着那一天:Artificial Analysis 承认他们哪里弄错了,或者 OpenAI 像当初处理 ARC 评分那样站出来,说明测试在测试框架或者类似环节出了问题。
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖