
用户实测Claude各版本中文写作:仍坚持使用旧版Opus 4.6
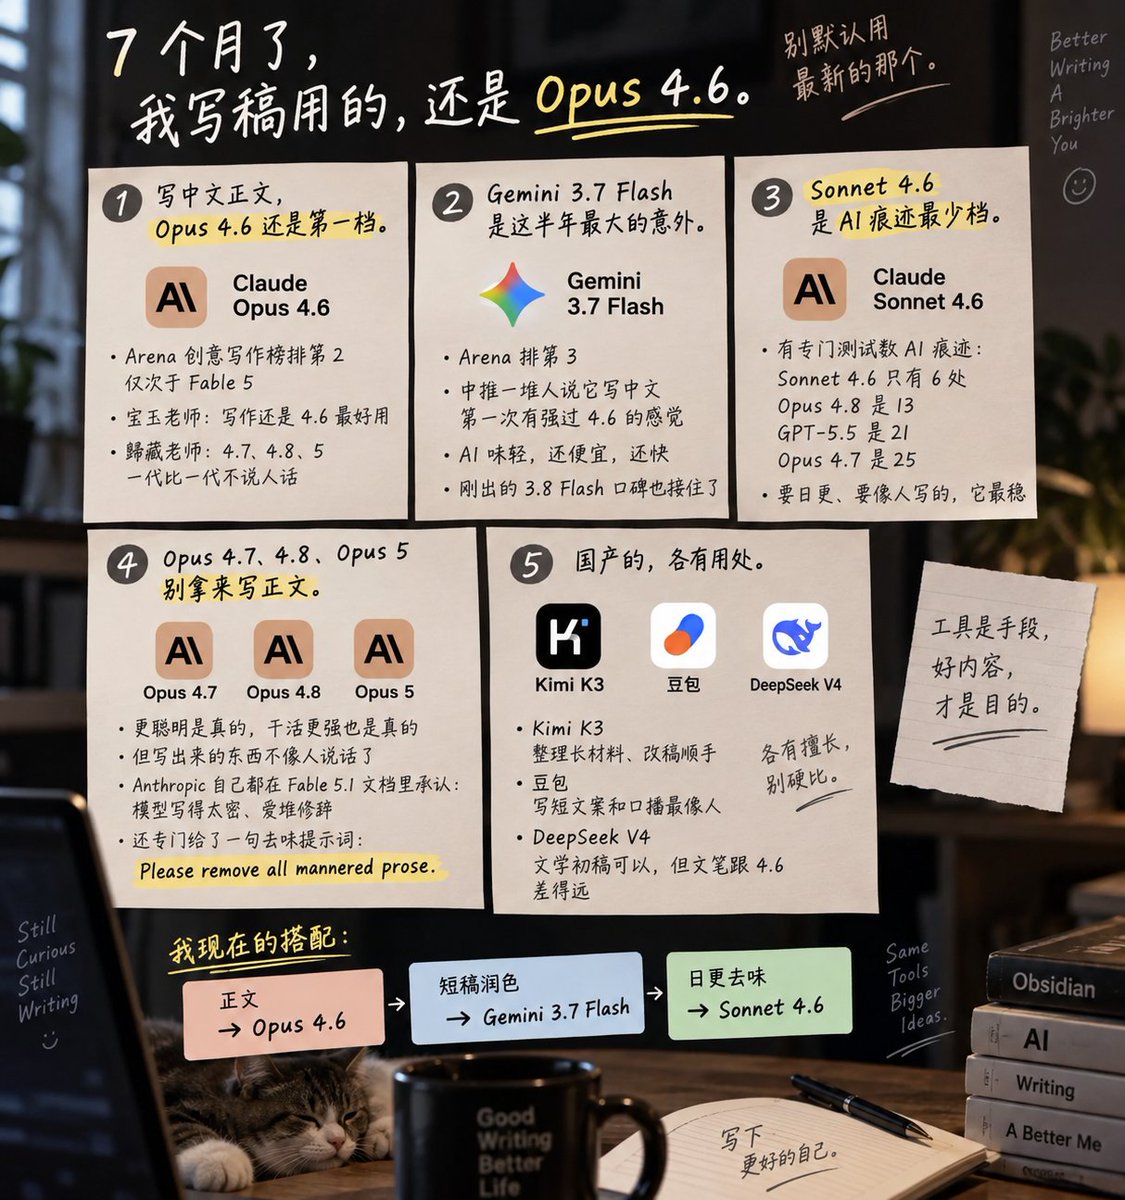
今年2月,@AI_Jasonyu曾发文称,Opus 4.6之后就成为他Obsidian里的常驻写作模型。
至今已经过去7个月,期间Anthropic陆续推出了Claude 4.7、4.8、Opus 5、Fable 5,本周又更新了Fable 5.1,但他一直还是在用4.6。
这不是因为懒得更换版本,而是每次更换新版本之后,写出来的内容读起来都感觉别扭。
前两天他用Sonnet 5修改一篇文章,改完之后AI生成的痕迹太重,他自己都看不下去,又切回了Opus 4.6。
本周他专门做了一轮验证,交叉对比了多个AI模型,查阅了Arena 9月2日的真人盲选投票榜,还整理了中文社交平台上几十条关于大模型写作的讨论,得到了统一的结论。
第一,写中文正文,Opus 4.6依然属于第一梯队。在Arena创意写作榜中它排名第二,仅次于Fable 5。有用户直接表示写作还是4.6最好用,也有用户称4.7、4.8、Opus 5一代比一代不说人话。
第二,Gemini 3.7 Flash是近半年最大的惊喜。它在Arena排名第三,不少中文用户认为它写中文的体验第一次超过了Opus 4.6,AI痕迹轻,速度快,价格还便宜。刚推出的3.8 Flash口碑也不错。
第三,Sonnet 4.6的AI生成痕迹最少。在一项专门统计AI痕迹的测试中,Sonnet 4.6只检测出6处,Opus 4.8有13处,GPT-5.5有21处,Opus 4.7有25处。需要日常更新、内容要像人写的,它最稳定。
第四,Opus 4.7、4.8、Opus 5不适合写正文。这些模型确实更聪明,处理任务能力更强,但写出来的内容不像人日常说话的风格。
Anthropic自己在Fable 5.1的文档中也承认,这些模型写出来的内容太紧凑,喜欢堆砌修辞,还专门给出了去除AI痕迹的提示词:Please remove all mannered prose。
第五,国产模型方面:Kimi K3整理长材料、修改稿件很顺手;豆包写短文案和口播内容最像真人写作;DeepSeek V4可以用来写文学初稿,但文笔和Opus 4.6差距较大。
目前@AI_Jasonyu固定了三组搭配:写正文用Opus 4.6,短稿润色用Gemini 3.7 Flash,日常更新去除AI痕迹用Sonnet 4.6。最后他提问,大家目前写内容主要用什么模型?