
GPT-6 Astra新增无限上下文扩展功能,可手动开启体验
🚨【必读】Astra 的最大变化:Context note 使用法🚨
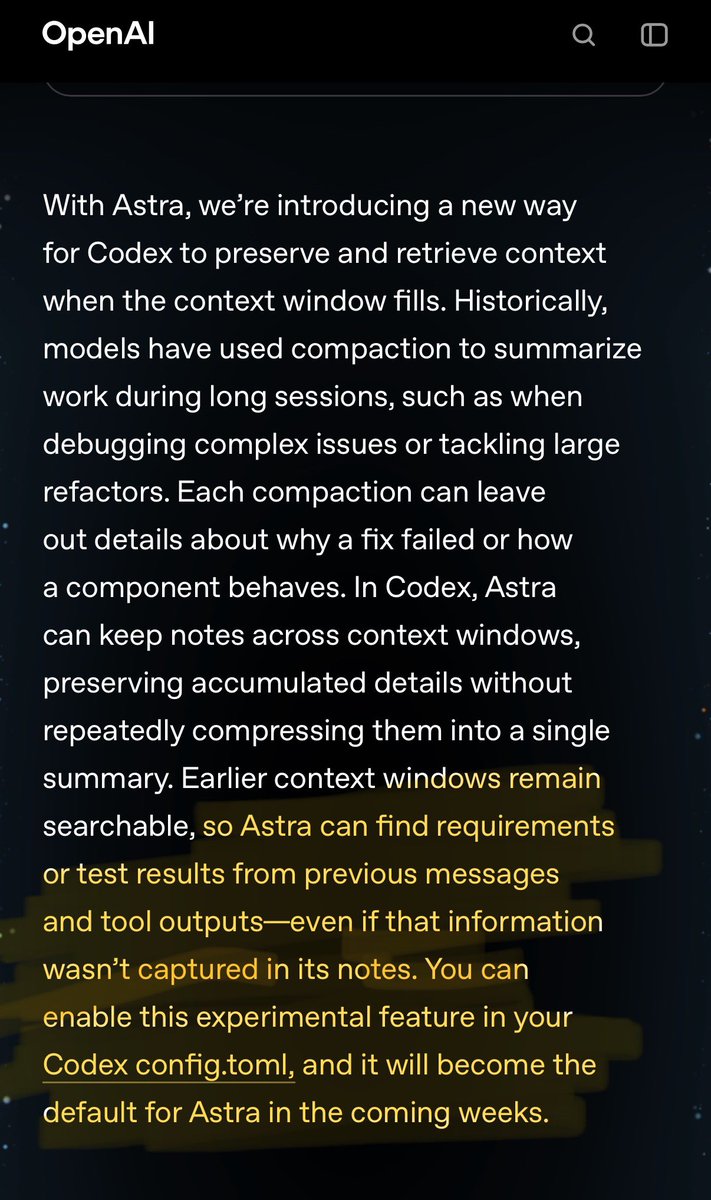
GPT-6 Astra 的最大变化出现在上下文占满的时候,就是通过「Note」实现的(稍微夸张点说)无限上下文扩展功能。
原先的 Codex 在窗口占满时会自动摘要,重复多次之后,旧上下文就会一点点消失。
Astra 不会把上下文反复压缩成一行摘要,而是会通过笔记和可搜索历史保留积累的细节。
这个功能默认是关闭的,几周后会成为 Astra 的默认设置,但现在需要你手动开启。
🔥🔥 一行开启方法 🔥🔥
只需要修改 `~/.codex/config.toml`,把 `[features.context_management]` 下的 `experimental_mode` 改成 `true` 保存就完成了。
已经打开的线程不会生效,如果你修改过 `CODEX_HOME`,那就修改对应路径下的 `config.toml`。放在用户配置里比放在项目本地的 `.codex/config.toml` 更安全。
👀 简单原理说明 👀
实验模式的工作原理就是把上下文保存为笔记,之后需要的时候再搜索。(就这么简单,为什么现在才做?)
默认的 Codex 在上下文达到 `model_auto_compact_token_limit` 时,会把之前的回合整块摘要。开启实验模式后会保存三个值:告知模型剩余上下文容量的令牌预算、上下文窗口改变后仍保留的笔记、不创建摘要而是打开新上下文窗口的 `new_context`。
工作开始后,在上下文窗口占满前,就会把限制、共识、失败的尝试、接下来要做的事记在笔记里。如果判断当前窗口已经难以继续处理,就会调用 `new_context`。
新的上下文窗口只会加载初始上下文和简短的笔记提示。提示为空或超过 4000 字节时会被省略,更多细节通过搜索历史调出。
---
这个功能会在几周内成为 Codex Astra 的默认设置,估计会和 9 月底的 OpenAI DevDay 一起更新 Codex 时正式切换。和之前强制扩展 1M 窗口不同,这次会成为正式默认设置,所以提前试用完全不会有问题,现在就试试吧!
本文由 AI 翻译自英文原帖,技术名词保留英文。
查看 X 原帖