
数千网站靠一个 llms.txt,让 AI 智能体跳过广告和导航拿到正文
背景
智能体现在会频繁使用网站:编码智能体抓取某个库的文档,以便把 API 调用写对;带搜索能力的聊天助手会读取网页,回答关于产品的问题。2024 年这份提案刚写成时,这很大程度上还是预测。今天它已是日常。这里补一句为什么重要:网页是给人看的,而智能体需要干净、可解析的文本,否则会浪费上下文和时间。
但网页是为人类构建的。一个 HTML 页面会把信息包在导航、广告和 JavaScript 里,再把它还原成干净文本既困难又不精确。上下文窗口虽然比过去更大,但对大多数网站的全部内容来说仍然太小,而且每个浪费的 token 都意味着时间和金钱。智能体最适合在单一、可访问的位置拿到简洁、专家级的信息。
这是提案的 v2,根据两年采用情况更新:数千个网站发布了 llms.txt 文件,文档平台会自动生成,Chrome 的 Lighthouse 也将其纳入智能体浏览检查,对站点进行审计。AI 实验室也为自己的开发者文档发布了 llms.txt:OpenAI、Anthropic 和 Gemini。变更页面说明了 v1 以来的变化及原因。
提案
我们提议在网站上添加一个 /llms.txt Markdown 文件,以提供 LLM 友好的内容。该文件可放在站点根目录,也可放在站点内任意路径下,覆盖该路径下的页面。这个文件提供简要背景、指引,以及指向详细 Markdown 文件的链接。
llms.txt 的 Markdown 既可供人阅读,也可供 LLM 阅读,但它同时采用精确格式,允许固定处理方式(即经典编程技术,如解析器和正则表达式)。
我们还提议:对于智能体可能需要的信息页面,应在与原始页面相同的 URL 提供干净的 Markdown 版本,可以在原 URL 后追加 .md(page.html.md),也可以把扩展名替换为 .md(page.md)。(没有文件名的 URL 应改为追加 index.html.md 或 index.md。)
为帮助客户端找到这些文件,我们建议使用标准链接关系:rel="alternate" type="text/markdown“ 指向页面的 Markdown 版本,rel=”describedby" 指向覆盖该页面的 llms.txt 文件。(一个 llms.txt 文件描述其路径下的所有页面,因此 /docs/llms.txt 覆盖 /docs/ 下的所有内容。)这些链接可以作为 HTML <link> 元素提供,也可以作为 HTTP Link: 响应头提供。响应头形式也适用于非 HTML 资源,例如 Markdown 文件本身,并且可以在 Web 服务器或 CDN 配置中添加,而无需修改任何页面。例如:
Link: </docs/page.html.md>; rel="alternate"; type="text/markdown", </docs/llms.txt>; rel="describedby"
FastHTML 项目的文档遵循了这两项提案。例如,FastHTML 文档的 llms.txt 放在 /docs/ 下,只覆盖文档页面。另有一个常规 HTML 文档页面的示例,以及与之相同 URL 但扩展名为 .md 的版本。
智能体应查看或搜索 llms.txt,找到所需信息,然后跟随相关链接。因此,llms.txt 文件中的链接应指向 LLM 友好的内容,例如上述页面的 Markdown 版本。文件本身保持足够小,以便放入上下文。细节藏在链接之后,只在需要时抓取。
llms.txt 文件最常用于软件文档:编码智能体会跟随它们找到 API 参考和教程。同样的结构也适用于任何需要智能体沿引导路径进入站点内容的场景:企业概述其结构和政策,个人网站回答关于某人简历的问题,或学校提供课程信息访问。
请注意,现在所有 nbdev 项目默认都会创建所有页面的 .md 版本。所有使用 nbdev 的 Answer.AI 和 fast.ai 软件项目的文档都已用此功能重新生成。示例可参见 fastcore 的 docments 模块的 Markdown 版本。
格式
目前,对语言模型来说最广泛、最易理解的格式是 Markdown。仅展示关键 Markdown 文件所在位置,就是很好的第一步。提供一些基本结构,有助于语言模型找到所需信息的来源。
llms.txt 文件的不寻常之处在于,它使用 Markdown 来组织信息,而不是 XML 等经典结构化格式。原因是,我们预计这些文件中的许多将由语言模型和智能体读取。话虽如此,llms.txt 中的信息仍遵循特定格式,并可使用标准的基于程序的工具读取。
llms.txt 文件规范适用于名为 llms.txt 的文件,位于网站根路径 /llms.txt 或任意子路径(例如 /docs/llms.txt)。一个文件覆盖其路径下的 URL;当有多个文件适用时,智能体应使用最具体的一个。符合规范的文件按以下特定顺序包含这些 Markdown 部分:
1. 可选的字节顺序标记(BOM)
2. 一个 H1,包含项目或站点名称。这是唯一必需的部分
3. 一个 blockquote,包含项目简短摘要,以及理解文件其余内容所需的关键信息
4. 零个或多个任意类型的 Markdown 部分(例如段落、列表等),但标题除外,包含关于项目及如何解释所提供文件的更详细信息
5. 零个或多个由 H2 标题分隔的 Markdown 部分,包含“文件列表”,即指向可获取更多详细内容的 URL
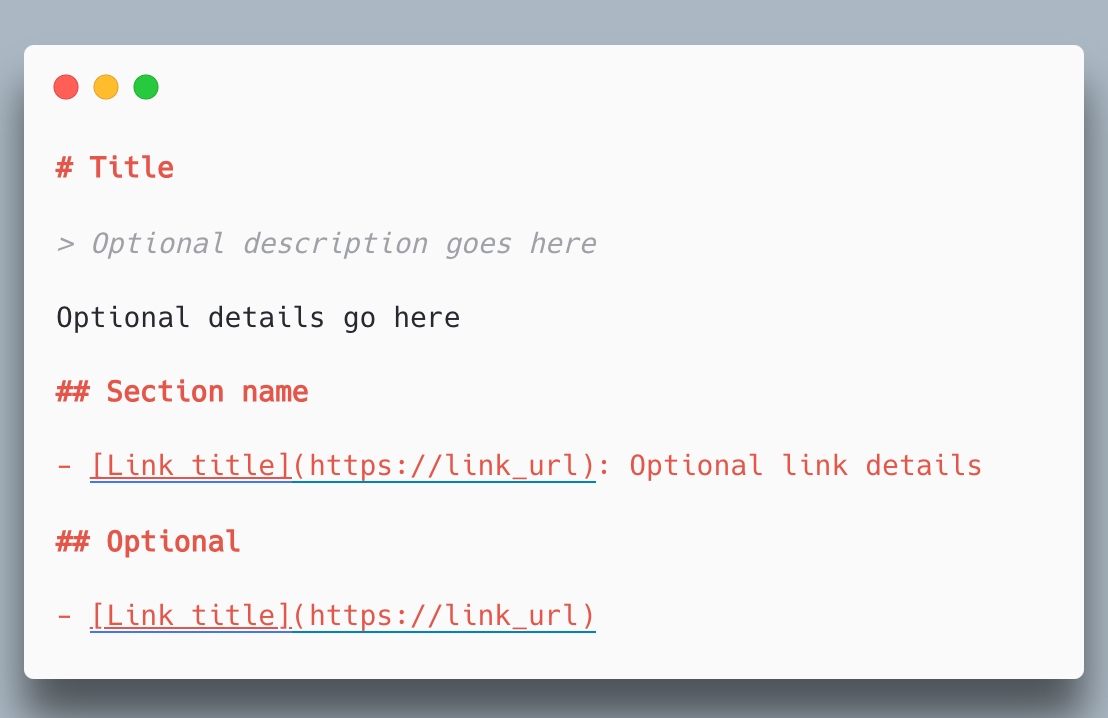
每个“文件列表”是一个 Markdown 列表,包含必需的 Markdown 超链接 name,然后可选地跟一个 : 和关于该文件的说明。
下面是一个模拟示例:
# Title

> Optional description goes here

Optional details go here

## Section name

- [Link title](https://link_url): Optional link details

## Optional

- [Link title](https://link_url)
按惯例,“Optional”部分用于次要信息:当需要更短上下文时,智能体可以跳过的链接。
与现有标准共存
llms.txt 旨在与当前 Web 标准共存。sitemap 为搜索引擎列出所有页面,而 llms.txt 为 LLM 提供经过整理的概览。它可以通过为允许内容提供上下文来补充 robots.txt。该文件还可以引用站点上使用的结构化数据标记,帮助 LLM 理解如何在上下文中解释这些信息。
使用标准文件名这一做法延续了站点根目录的 /robots.txt 和 /sitemap.xml。正如 index.html 为任意路径提供人类可读入口的常规位置,llms.txt 为任意路径提供 LLM 可读概览的常规位置。robots.txt 和 llms.txt 目的不同。robots.txt 让自动化工具知道对站点的何种访问可被接受,例如用于搜索索引机器人。llms.txt 信息则按需使用:当智能体在协助用户时需要某主题的信息。我们原本预期 llms.txt 主要用于推理而非训练,实际使用也是如此,不过训练任务也可以利用这些信息。
另一种方案是 Well-Known URIs 标准(RFC 8615),它为这类元数据文件保留了 /.well-known/ 前缀。但 well-known URI 只存在于源根目录,而许多作者只控制共享主机上的某个路径:例如 GitHub Pages 项目站点可以在自己的目录中发布文件,却永远无法向主机的 /.well-known/ 添加文件。像 index.html 一样,llms.txt 描述它所在的路径,这是单一根位置无法表达的。而且,任何能在某个路径发布内容的人都可以提供它。
sitemap.xml 是站点上所有可被索引的人类可读信息的列表。它不是 llms.txt 的替代品,因为:
- 它通常不会列出页面的 LLM 可读版本
- 它不包含指向外部站点的 URL,尽管这些 URL 可能有助于理解信息
- 它一般会覆盖总体上过大、无法放入 LLM 上下文窗口的文档,并包含大量理解站点所不需要的信息
示例
下面是 llms.txt 的一个示例,这里是 FastHTML 项目所用文件的精简版本(另见完整版本):
# FastHTML

> FastHTML is a python library which brings together Starlette, Uvicorn, HTMX, and fastcore's `FT` "FastTags" into a library for creating server-rendered hypermedia applications.

Important notes:

- Although parts of its API are inspired by FastAPI, it is *not* compatible with FastAPI syntax and is not targeted at creating API services
- FastHTML is compatible with JS-native web components and any vanilla JS library, but not with React, Vue, or Svelte.

## Docs

- [FastHTML quick start](https://fastht.ml/docs/tutorials/quickstart_for_web_devs.html.md): A brief overview of many FastHTML features
- [HTMX reference](https://github.com/bigskysoftware/htmx/blob/master/www/content/reference.md): Brief description of all HTMX attributes, CSS classes, headers, events, extensions, js lib methods, and config options

## Examples

- [Todo list application](https://github.com/AnswerDotAI/fasthtml/blob/main/examples/adv_app.py): Detailed walk-thru of a complete CRUD app in FastHTML showing idiomatic use of FastHTML and HTMX patterns.

## Optional

- [Starlette full documentation](https://gist.githubusercontent.com/jph00/809e4a4808d4510be0e3dc9565e9cbd3/raw/9b717589ca44cedc8aaf00b2b8cacef922964c0f/starlette-sml.md): A subset of the Starlette documentation useful for FastHTML development.
要创建有效的 llms.txt 文件,可考虑以下指南:
- 使用简洁、清晰的语言。
- 链接到资源时,附上简短、信息量充足的说明。
- 避免含糊的术语或未解释的行话。
- 通过只把 llms.txt 作为起点,向智能体提问关于内容的问题,来测试文件。
公开目录
以下是几个列出网上可用 llms.txt 文件的目录:
- llmstxt.site
- directory.llmstxt.cloud
- llmstxthub.com
集成
许多文档平台和 CMS 可以自动生成 llms.txt 文件:
- Mintlify:文档平台,为其托管的每个站点生成 llms.txt 和 Markdown 页面版本
- GitBook:为已发布的文档站点提供 llms.txt 文件
- Yoast SEO:WordPress 插件,生成并维护 llms.txt 文件
- AIOSEO:带有 llms.txt 生成器的 WordPress 插件
- Wix:为每个 Wix 站点生成 llms.txt 文件
此外,还有各种库和插件可用于将 llms.txt 规范集成到你的工作流:
- JavaScript Implementation:示例 JavaScript 实现
- vitepress-plugin-llms:VitePress 插件,按照 llms.txt 规范自动为网站生成 LLM 友好文档
- docusaurus-plugin-llms:Docusaurus 插件,按照 llmtxt.org 标准生成 LLM 友好文档
- Drupal LLM Support:Drupal Recipe,在任何 Drupal 10.3+ 站点上完整支持 llms.txt 提案
- llms-txt-php:用于读写 llms.txt Markdown 文件的库
- VS Code PagePilot Extension:PagePilot 是 VS Code Chat 参与者,自动加载外部上下文(文档、API、README 文件)以提供增强响应。
- server-llm-txt:MCP(Model Context Protocol)服务器,让智能体抓取和搜索 llms.txt 文件
后续步骤
llms.txt 规范开放社区意见。一个 GitHub 仓库托管这份非正式概览,支持版本控制和公开讨论。还有一个社区 Discord 频道,可用于分享实现经验和讨论最佳实践。