
Meta发布Muse Ember,渲染效果与贵40倍的Muse Wonder相当
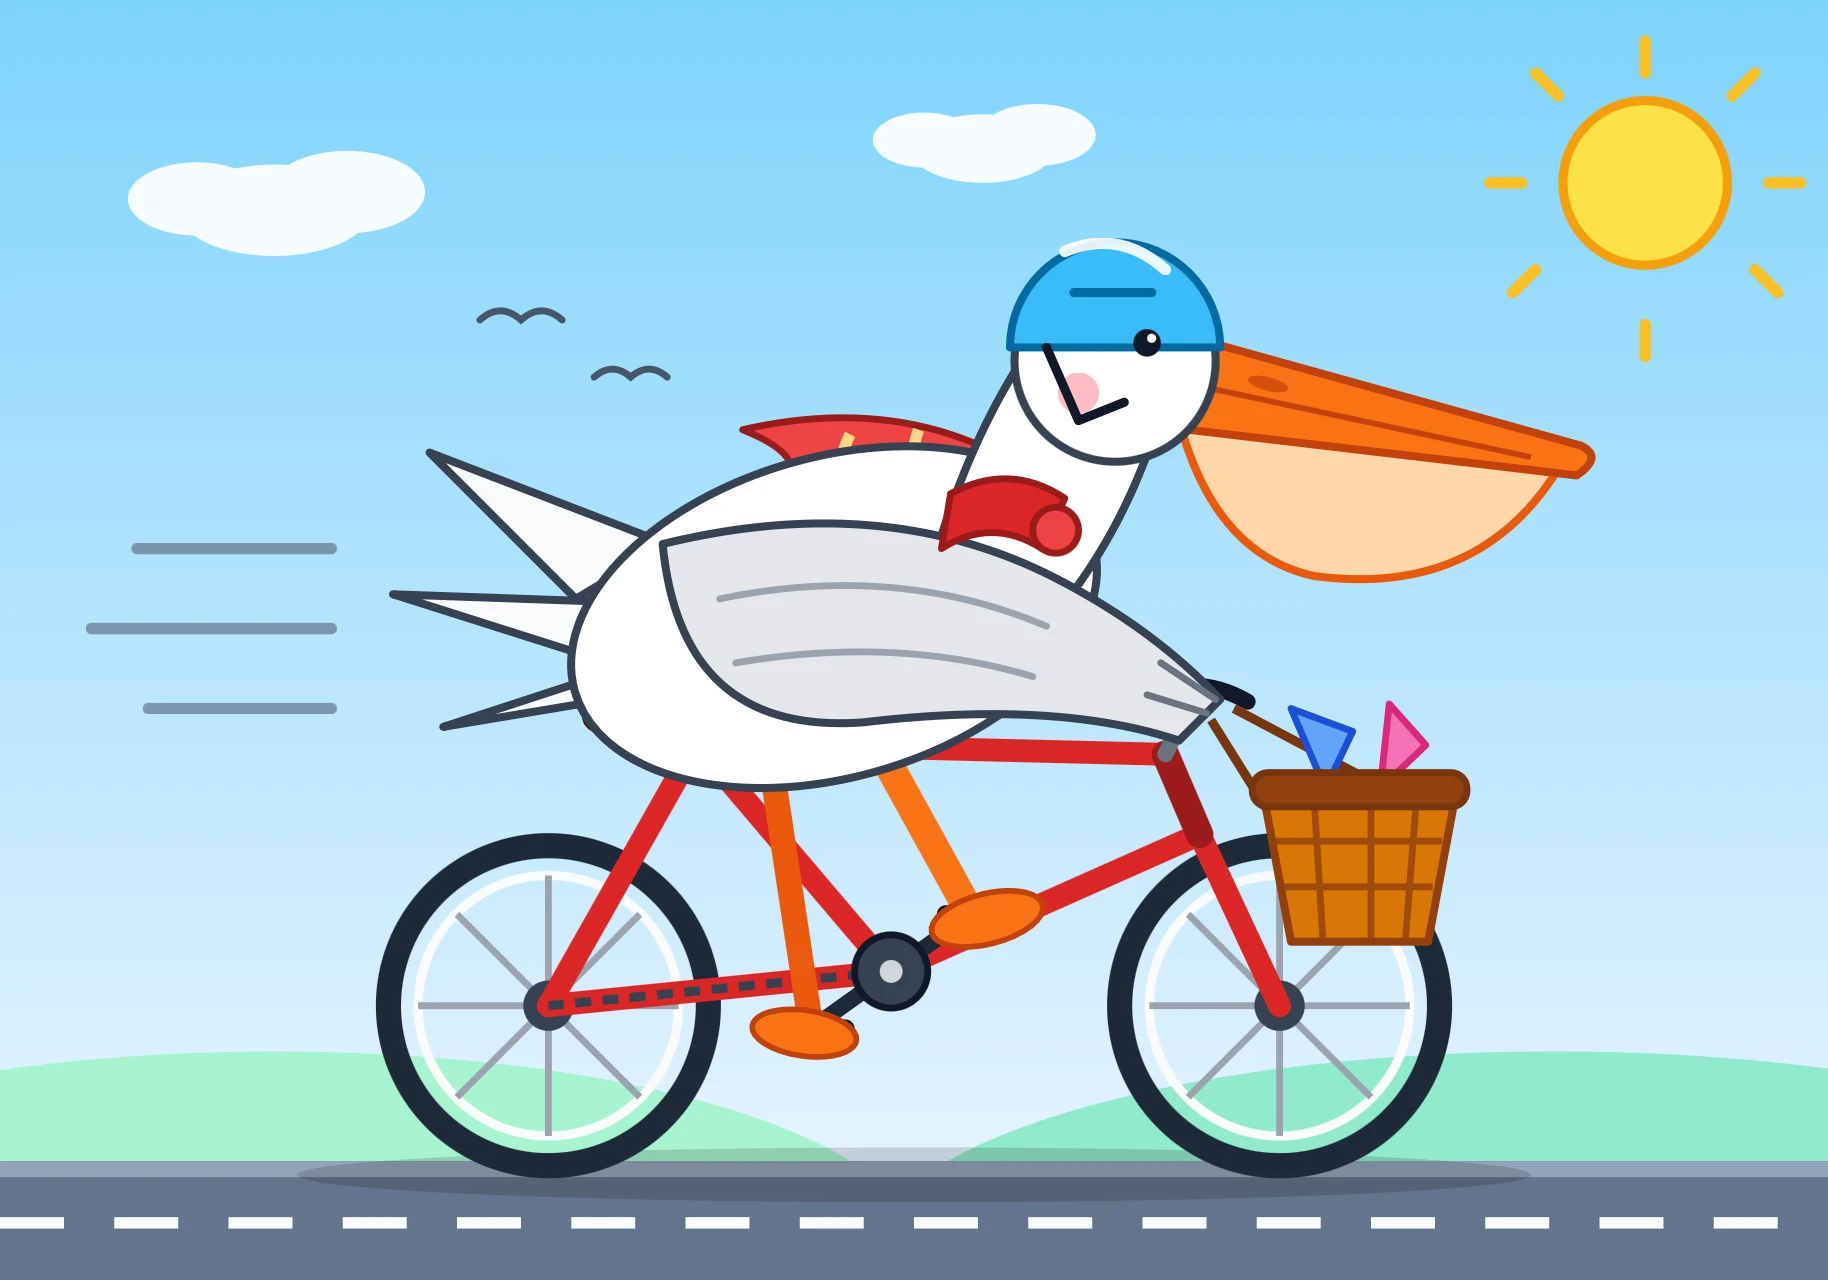
Meta AI 发布了 Muse Ember。这是它最小、最高效的模型,和 Claude Haiku、GPT Luna 摆在同一个类别里。它接的活很具体:AI 代理每天反复执行的那些。工具调用、编码子任务、路由、提取、长文档解析。
短提示下,Muse Ember 的价格和 GPT-6 Luna、Claude Haiku 5.5 完全一样:输入每百万 token 0.10 美元,输出 0.50 美元。同一天发布的 Claude Fable 5.2 是 8 美元和 40 美元,正好是它的 80 倍。
三个模型都支持最多 100 万输入 token,但各自有门槛,过了就跳档。GPT-6 Luna 的线在 272k 以上:输入 0.20、缓存 0.02、输出 0.75。Muse Ember 1.0 的线在 200k:超过后输入 0.30、缓存 0.012、输出 1.50。Claude Haiku 5.5 门槛最低,100k 以上输入直接到 0.50、缓存 0.05、输出 2.50。按长提示算,Ember 的定价夹在另外两个之间。
只看每 token 单价已经不够。推理 token 让不同模型解决同一个问题所用的 token 数差别很大,单价拉不平实际花费。Artificial Analysis 把智能分数和每任务成本画在同一张图上,这个角度更实用。Muse Ember 就落在帕累托前沿线上——想在一个维度上提高,只能牺牲另一个。Meta 的说法更绝对:在整张 Artificial Analysis 排行榜的效率前沿上,没有模型能以更低成本拿到更高分数。图上还压着一个灰点,是 GPT-6.1 Terra (low),那个系列值得多看几眼。
Muse Ember 提供六个推理级别:minimal、low、medium、high、xhigh、max。有人拿六个骑自行车的鹈鹕做 SVG 渲染测试,high 级别没能返回完整图像。其余几个级别的输出,质量并没有干净地对应到推理级别的高低。把档位拨高不一定换来更好结果,具体任务得具体试。
质量本身不差。Ember 渲染的鹈鹕和 Muse Wonder 出来的差不多,而 Muse Wonder 的价格是 Ember 的 40 倍。
复杂推理任务上,Ember 还没有独立数据。缓存输入压到了 0.004 美元每百万 token,但这笔便宜在多少场景里成立,没有展开。六个级别之间的差异落在哪类任务上最明显,也还空着。40 倍的差价能不能守住,答案在这些空着的地方。
关键事实
- Meta AI发布了Muse Ember,是其最小、最高效的模型,定位在Claude Haiku/GPT Luna类别。
- Muse Ember被描述为用于复杂推理执行和代理重复性工作的最小、最高效模型,包括工具调用、编码子任务、路由、提取和长文档解析。
- 对于较短的提示,Muse Ember的定价与GPT-6 Luna和Claude Haiku 5.5相同:输入$0.10/百万token,输出$0.50/百万token。
- Claude Fable 5.2的价格是Muse Ember的80倍,为$8/$40(输入/输出每百万token)。
- 三个模型(Luna、Ember、Haiku)都支持最多100万输入token,但都有阈值,超过后价格上升。
- Muse Ember的定价在长提示下介于GPT-6 Luna和Claude Haiku 5.5之间。
- 比较每token价格不再有意义,因为推理token意味着不同模型可能使用不同数量的token来解决相同问题。
- Muse Ember模型位于帕累托前沿线上,即只能通过牺牲一个维度来改进另一个维度。