
免费本地GLM接下七成编码,GPT-6.1 Sol只做规划与检查
在目前的工作中,我们有好几台 H200 GPU 服务器 :)。几周前,我在其中一台上面部署了 GLM-5.3-Flash,目标是让它成为我的主要编码模型和开发主力,从而减少对 Claude Code 和 Codex 的使用。如果这套方案行得通,我甚至能带动队友也来用它 🙈。
毫无疑问,Claude Opus 5.5、GPT-6 Astra 或 GPT-6.1 Sol 这类模型目前是最强的,处理复杂任务时远超开源模型。但没人能忽视使用它们的高昂费用,以及随时可能触及用量上限或耗尽积分的焦虑。
GLM-5.3-Flash 是免费的,跑在一台 4-GPU H200 服务器上,对中低复杂度的任务足够好用。它还是 MoE 模型(总参数 320B,只有 18B 激活),所以速度很快。我用 512K 上下文窗口提供服务,必要时可以毫无压力地扩展到同时支持 8 到 10 个人。
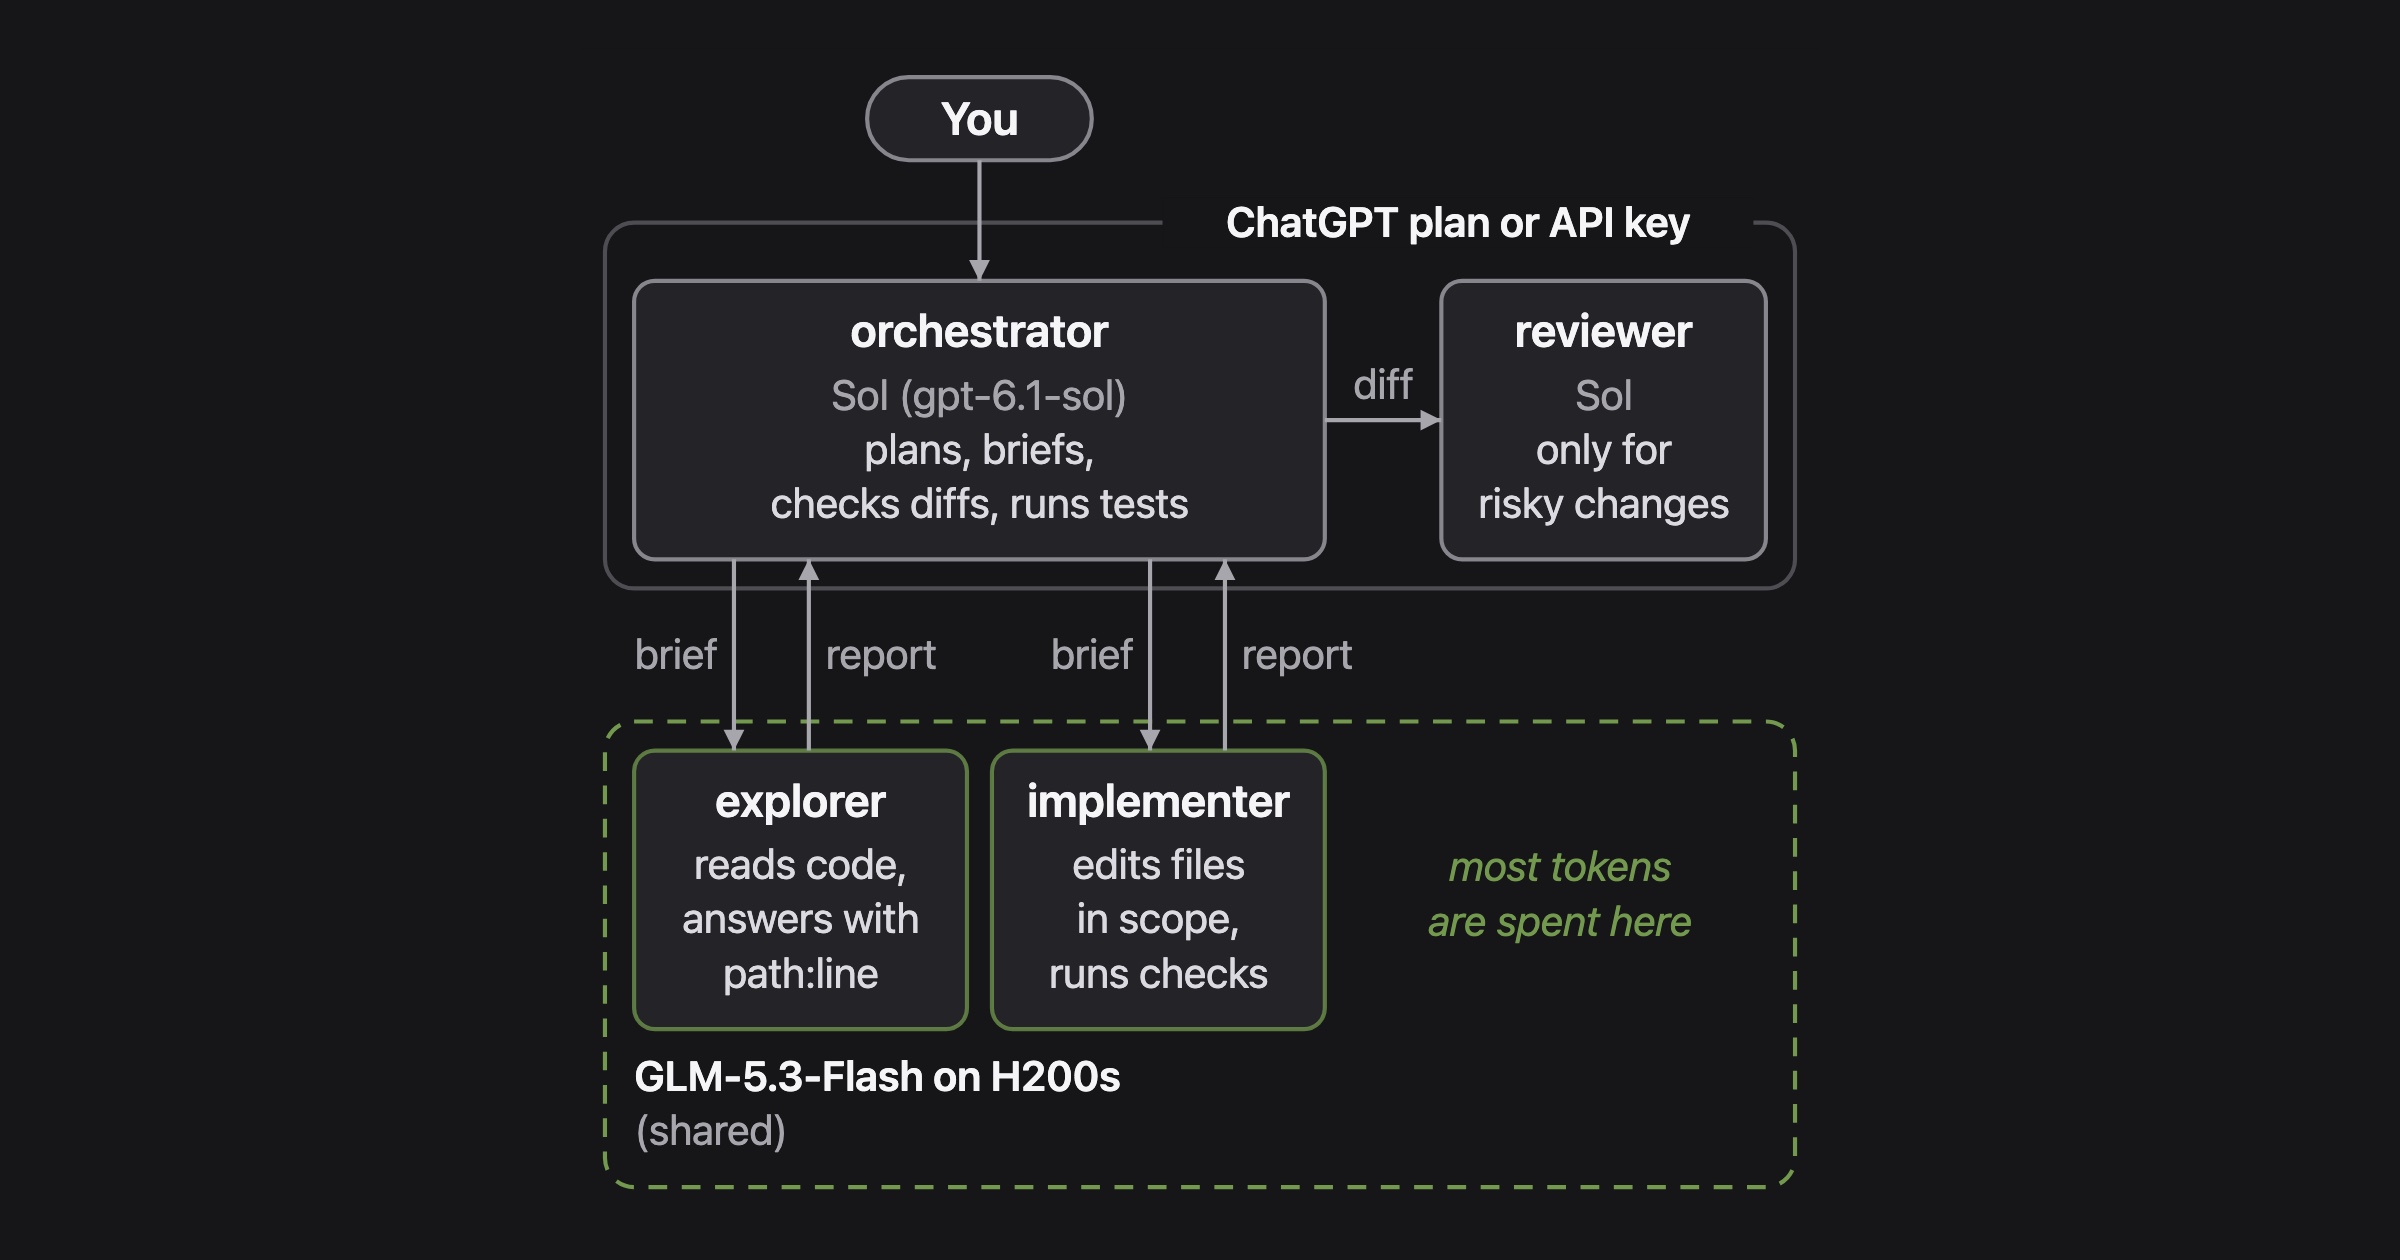
根据我的经验,我不会把所有任务都切换给它,但它和 Sol(或许也可搭配 Opus 5.5)配合得很好。与其让整个会话只由一个模型运行,不如让 Sol 负责规划、写 brief、读 diff、跑检查,GLM 负责读代码、做修改、跑测试并在失败时迭代。Sol 还能发现 GLM 漏掉的问题。这样,plan 限制(或 API 账单)都花在判断上,而大部分 token 消耗在自家 GPU 上。
这里没有任何东西依赖 GLM,你可以部署这个模型或任何其他模型,甚至像 Qwen3.8-27B 这样单 GPU 就能跑的模型也完全可以。
选择哪个 harness
理想情况下,我很想把这个模式用在 Claude Code 或 Codex 上,因为我更熟悉它们,而且两者的 harness 都很完善。但我发现,要让主会话跑在 Sol 或 Opus 5.5 上,同时让子代理在本地部署的模型(例如 GLM-5.3-Flash)上干活,并不容易,甚至可能根本做不到。
例如在 Codex 中,我设置了一个指向 GLM 服务器的 glm_implementer 代理角色。Codex 确实加载了这个角色,但仍把请求发往 OpenAI,所以子代理立刻失败,报错:The 'coder-glm' model is not supported when using Codex with a ChatGPT account。
这个问题其实已经记录在 Codex 的子代理文档里,也早有 open issue 在要求解决(#40858、#47752)。Claude Code 也有同样的限制:子代理可以选不同模型,但不能选不同 endpoint(端点,见文档)。
所以我觉得,OpenCode 或 Pi 这类编码 harness 才是更合适的选择。它们灵活得多、可定制性强,而且不绑定单一 provider。
OpenCode 用 provider/model 的格式命名模型,每个 agent 或 subagent 都可以从不同 provider 选择自己的模型——这正是这套方案最需要的关键特性。我的本地 GLM provider 使用 @ai-sdk/openai-compatible 适配器,所以它只讲标准 Chat Completions,工具调用和流式输出都能正常工作。
Pi 是另一个选项。它没有内置的子代理,但它的示例扩展允许每个 agent 选择自己的模型,包括 models.json 中自托管的模型。
我选择 Sol(或其他 ChatGPT 模型)作为主模型还有一个原因:登录。OpenCode 可以用 ChatGPT 套餐登录,OpenAI 也允许这样做,因为它的 Sign in with ChatGPT 页面把 OpenCode 和 Pi 都列为开源集成。Anthropic 的条款则把 Pro 和 Max 套餐限定在 Claude Code 及其自家应用里,所以 Opus 5.5 需要 API key。
具体配置
根据我的经验,一个有效又简单的分工是这样的:
- Sol:负责规划和检查;
- H200 上的 GLM:负责读代码和改代码;
- 还有一个基于 Sol 的 reviewer:只看有风险的改动。
我在主会话里和 orchestrator 对话,它跑在 Sol 上。orchestrator 会把 brief 发给跑在 H200 GLM-5.3-Flash 上的 explorer 和 implementer,并自己检查它们的报告。reviewer 也跑在 Sol 上,只在出现有风险的改动时介入。
下面是 ~/.config/opencode/opencode.json(base URL 是占位符,真实文件里还有权限规则和其他设置):
{
  "$schema": "https://opencode.ai/config.json",
  "model": "openai/gpt-6.1-sol",
  "default_agent": "orchestrator",
  "provider": {
    "glm": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "GLM-5.3-Flash",
      "options": {
        "baseURL": "https://<your-server>/v1",
        "apiKey": "{file:~/.config/glm/api_key}",
        "timeout": 900000
      },
      "models": {
        "coder-glm": {
          "name": "GLM-5.3-Flash",
          "tool_call": true,
          "reasoning": true,
          "limit": { "context": 524288, "output": 131072 }
        }
      }
    }
  },
  "agents": {
    "general": { "disabled": true },
    "explore": { "disabled": true },
    "title": { "model": "glm/coder-glm" },
    "summary": { "model": "glm/coder-glm" }
  }
}
目前这台服务器可以和团队共享,忙的时候请求可能会在队列里等几分钟,所以客户端超时设成了 15 分钟,每个会话最多同时运行 3 个 GLM 代理。
general 和 explore 是 OpenCode 内置的子代理,它们默认会使用默认模型(Sol),所以这里把它们禁用掉,于是 orchestrator 只能把工作派给下面这些代理。title 和 summary 是小型维护类调用,也走 GLM。
我把这些代理设成了全局的,因此在 ~/.config/opencode/agents/ 下每个代理只有一个 markdown 文件。orchestrator 和 reviewer 跑在 Sol 上,explorer 和 implementer 跑在 glm/coder-glm 上。
orchestrator 是默认代理,下面是精简后的 orchestrator.md:
---
description: Leads the work. Plans, delegates to explorer and implementer, verifies results, reports back. Does not implement.
mode: primary
model: openai/gpt-6.1-sol
permissions:
  - { action: edit, resource: "*", effect: ask }
  - { action: subagent, resource: "*", effect: deny }
  - { action: subagent, resource: explorer, effect: allow }
  - { action: subagent, resource: implementer, effect: allow }
  - { action: subagent, resource: reviewer, effect: allow }
---

You lead the work: plan, delegate, verify. You do not implement.

- Use `explorer` for any question that needs reading more than a couple of files.
- Hand implementation to `implementer` as tasks with separate file sets. Each brief states the goal, files in scope, what done means, and the commands to run.
- At most 3 GLM agents (explorer, implementer) at once; the GLM server is shared. Never give two implementers the same file.
- Verify every result yourself: read the diff, run the checks. Send concrete failures back to the same implementer. After two failed rounds on one issue, ask me before fixing it yourself.
- Use `reviewer` only for changes that cut across several files or are risky.
我通常把 prompt 写得很短,只给方向而不是逐步指令,因为这些模型都有推理能力,不需要太详细的引导。我的 implementer prompt 只有三条规则:不超出范围;如果 brief 和代码对不上,停下来把两种理解都报告出来;没跑过的东西绝不说通过。
另外,你还需要设置权限规则,因为 OpenCode 不会像 Codex(macOS 上的 Seatbelt)那样对代理做沙箱隔离(见 SECURITY.md)。例如在早期测试中,我的 GLM implementer 自己就 pip 安装了 pytest。权限规则是一个有序列表,最后一个匹配生效(见文档)。我的做法是:对任何 shell 命令都先询问,除非是只读 git、rg、构建、测试和 lint。最好用规则挡住意外命令——凡是出现 >、.env、绝对路径、home 路径或 ../ 的命令都先问一次。
一个示例
真实的会话是客户项目,没法分享;这里为了完整性,我加了一个非常简单的例子。这次我让 orchestrator 往一个小 Python 模块里添加一个带测试的 longest_word(text) 函数。它把任务交给 implementer,然后自己运行了 git diff、python3 -m unittest 和 git diff --check。它还发现新测试里用的 “Hello, World! It’s me.” 中 hello 和 world 都是五个字母,打平了,于是把同一个 implementer 派回去加强测试(“Hi, WONDERFUL world!”),等 7 个测试全部通过后才收工。
运行结束后,opencode stats --project . --models --cost 显示 GLM 用了 104.6k tokens,Sol 用了 68.2k tokens,所以即使是这个玩具任务,也有大约 60% 的 token 被送到了 GLM(GLM 显示 $0.00 只是因为自定义模型没有设置价格)。
在更大的实现任务上,这个比例会更高:大约 70-75% 的 token 给 GLM,只有 20-25% 给 Sol。至于怎么在 H200 上部署这个模型,也许可以下次再单独写一篇。