
让AI批量生成的文本更易读的五大原则
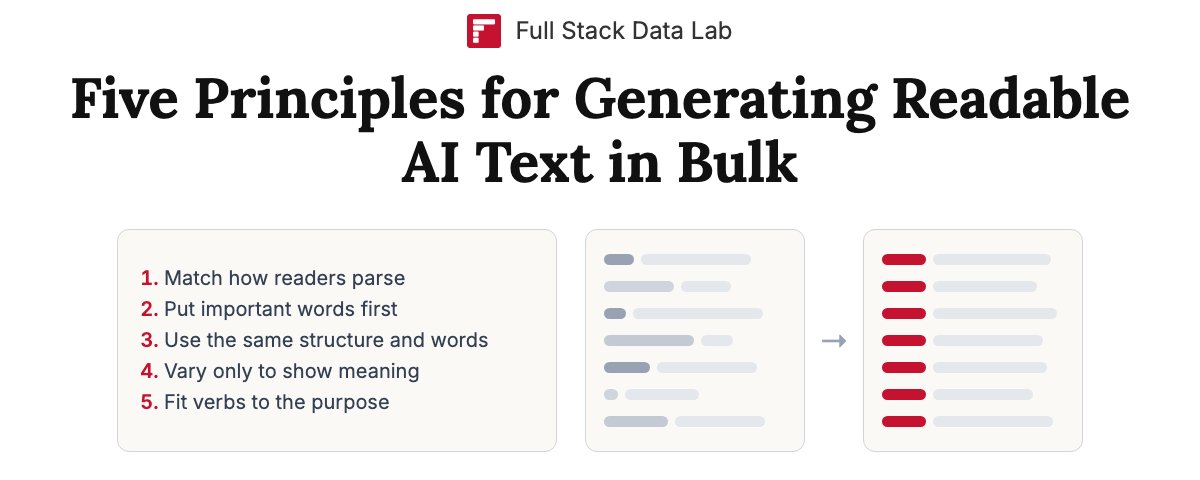
问题
得益于现代AI,我们人类正以前所未有的规模阅读AI生成的文本!我们的许多日常主力产品都在展示此类文本的信息流:例如,在Claude Code或Codex中,侧边栏会展示我们过往代理会话的AI生成标题;在iPhone上,Apple Intelligence现在会对通知的“堆叠”进行分组和总结。人们还会用AI生成大量临时仪表盘和网页,并广泛分享。
遗憾的是,这类AI生成的文本信息流对人类来说相当难读。这并不令人意外,因为众所周知,文本条目需要具备可预测性和一致性,人类才能快速阅读大量条目。
在这篇博客文章中,结合我们最近用AI生成文本仪表盘(并在仪表盘中消费大量AI生成文本)的经验,我们提出了一份包含5条原则的检查清单,用于生成有效的AI文本信息流。
检查清单
1. 匹配人类读者解析句子的方式
有趣的是,人类解析文本的方式相当可预测且简单,而且我们很早就知道这一点。1970年,研究人们如何理解句子的心理语言学家Thomas Bever发现,英语读者会使用“NVN”策略:他们把第一个名词当作主语,把接下来的动词当作它的动作,把再下一个名词当作它的宾语。[1] 例如,在“The agent fixed the login bug”中,读者把“agent”当作主语,“fixed”当作动作,“bug”当作宾语。
因此,如果文本不符合NVN模式,人类就需要多遍阅读文本,这相当令人恼火。[2] 例如,在“Login bug fixed by the agent”中,读者首先把“bug”当作主语,把“fixed”当作它的动作,就好像bug修复了什么东西。直到看到“by the agent”,读者才找到真正的主语,然后重新解析这句话。
为了让读者以尽可能少的认知努力来阅读文本条目列表,这里有一个粗略的流程可循:
- 每条以主语或动词开头。如果所有条目的主语相同,就省略主语,直接以动词开头。
- 把每条的第一个动词放在最符合读者预期的时态:过去时、进行时或将来时。
示例。我们许多人每天都在使用编码代理应用,例如Claude或Codex。应用的侧边栏会显示代理会话列表。图1(左)展示了Claude侧边栏的一个真实例子。标题混合了名词(“KV persistence”)、动名词(“Switching to main”)和祈使句(“Fine-tune model on personal writing”)。右侧是使用上述流程改写后的相同标题。
所有会话的主语都是同一个,即代理(agent),因此按照上述流程,每个标题都应该以动词开头。然后,由于每个会话都仍在进行中,每个动词都使用进行时形式,例如“Measuring vLLM performance”。
图1. 来自作者Claude侧边栏的七个会话标题,经过风格化处理(左),以及改写为以进行时动词开头的相同标题(右)。
2. 把最重要的词放在最前面
Jakob Nielsen是一位非常著名的可用性研究员,研究人们如何阅读网站。他用眼动追踪发现,读者以“F”形模式扫读网页:他们阅读每行的开头,跳过其余大部分内容[3]——而且,列表的读者往往只看到每条的前两个词。[4] 因此,我们应该:
- 找出使每条内容区别于其他条目的词语。
- 把这些词尽量移到条目开头。
示例。如图2所示,写订单邮件主题的一种糟糕做法是把状态放在最后,例如“Your order #1001 has shipped.”。这样每个主题都以相同的词开头。但亚马逊把状态放在开头,例如 Ordered: “Bounty Essentials...”。
图2. 收件箱中的订单邮件,经过风格化处理。当状态放在最后时(左),每封邮件的前几个词都相同。当状态放在开头时,如亚马逊订单邮件(右),第一个词就能区分不同邮件。
3. 使用相同的结构和词汇
在1980年代的另一项有趣的心理语言学研究(由Lyn Frazier和她的同事进行)中,研究者测量了人们阅读由“and”连接的两个分句的句子的速度。当第二个分句与第一个分句结构相同时,读者读得更快,例如当两个分句都是主动语态或都是被动语态时。[5] 人们可以直接把这一想法应用于文本列表:当每条内容与前面的条目结构相同时,读起来会更快。[6]
此外,众所周知,一段文本不应对同一概念使用两个不同的词。[7] 因此,在文本列表中:
- 每条内容使用同一种结构。
- 每个概念使用一个词。
示例。我们先展示一个不符合这条原则的例子,再展示一个符合的。对于反面例子,我们展示Notion中的AI自动填充功能——它会为Notion表格中的每一行写一条摘要。我们制作了一个包含Ollama的10个公开GitHub issue的表格,让Notion AI填充一个Summary列。[8] 如图3所示,这些摘要实际上很难快速扫读。摘要的开头不一致:有的以“The issue reports that”开头,有的以“The page reports”开头,有的以动作描述(“Pressing Ctrl+C”)开头;并且在某些行中把同一个东西称为“issue”,在另一行中称为“page”。
图3. Notion表格中的四行,经过风格化处理。Notion AI根据issue的文本编写了每条摘要。高亮标记显示了每条摘要的开头。
相比之下,Perplexity的Discover信息流很好地遵循了本清单第3条(以及第1条)。[9] 如图4所示,每条标题都有相同的结构:主语、现在时动词、然后是宾语,例如“Bank of Canada hikes rate to 2.5%”和“Brewers beat Rays in Game 5 for first World Series title”。
图4. 来自2026年10月28日Perplexity Discover信息流的四条新闻,经过风格化处理。每条标题都有相同的结构。
4. 仅在表达有意义差异时使用变化
1986年,可视化研究者(也是现代数据可视化的先驱)Jock Mackinlay写了一篇关于如何自动设计图表的论文。[10] 其核心思想之一是表现力(expressiveness):图表应该表达数据中的所有事实,且只表达数据中的事实。例如,如果柱状图中有一根柱子是红色的,读者会认为这个颜色有意义——所以要确保柱子的任何变化都对应某个有意义的变量。[11] 虽然这项研究针对的是结构化(即表格化)数据的图表,但将其应用于非结构化文本也并非牵强:如果列表中的某条内容在其他条目中显得不同,例如在长度、结构或用词上,读者会认为这种差异有意义。
示例。LLM经常被用来总结用户反馈中的“关键主题”。我们在100条最近的Duolingo App Store评论上运行了Claude的数据分析插件,看看前沿模型会怎么做。[12] 在图5的左侧,每张卡片都添加了不同类型的细节。只有bugs卡片提到了应用版本号(7.146.0),只有energy卡片提到一些评论是俄语和土耳其语的。因此读者无法判断这些细节是否重要:7.146.0是唯一存在bug的版本吗?其他主题只来自英语评论吗?
在右侧,我们重写了每张卡片,使每张卡片都有相同的组成部分:一句关于用户反馈内容的话,后面跟着一条来自评论的示例。我们还用柱状图展示了每个主题的评论数量——这是一个重要变量。当然,改写后的卡片会丢失一些细节,但读者仍然可以打开他们关心的任何主题的评论。
图5. 由Claude通过其数据分析插件生成的100条Duolingo App Store评论关键主题仪表盘,经过风格化处理(左;展示了11个主题中的5个)。右侧是使用同一模板改写后的相同主题,每个主题的评论数量以柱状图显示。点击卡片或柱状图可在三个视图中高亮同一主题。
5. 让动词的情感色彩与仪表盘的目的对齐
许多仪表盘的存在是为了呈现某一种信息,例如客户不喜欢什么,或者客户喜欢什么、什么事情进展顺利。仪表盘中的动词应该让目的显而易见。例如,客户投诉仪表盘应该使用明确的负面动词,如“complain”,而赞美仪表盘应该使用明确的正面动词,如“love”。读者扫读仪表盘时注意力很低,因此带有强烈情感色彩的动词有助于读者快速理解每条内容。[13]
示例。在图5中,Claude的版本以“Chess is a popular new draw”开头,尽管卡片的大部分内容都在列举投诉。因此读者无法一眼看出该主题是好消息还是坏消息。在我们的版本中,每张卡片都以具有明显情感倾向的动词开头,例如赞美用“Users love”,问题用“Users complain”,读者仅凭动词就能判断一个主题是赞美还是投诉。
要点总结
在这篇文章中,我们讨论了让大量AI生成文本易于阅读的五条原则。虽然我们只讨论了简单的仪表盘式示例,但我们相信这些原则适用于AI生成的任何工件或产品,例如网站。所以,请把这份检查清单喂给你的编码代理,或者把它做成一个技能,让你的AI生成文本对人类来说易于阅读。让我们一页一页地走向一个没有垃圾内容的世界。
注释
[1] Thomas G. Bever. The Cognitive Basis for Linguistic Structures. In J. R. Hayes, editor, Cognition and the Development of Language, pages 279–362. Wiley, New York, 1970. Bever将该策略描述为:把名词、动词、名词分别解读为动作的施行者、动作和动作的对象。
[2] Lyn Frazier and Keith Rayner. Making and Correcting Errors During Sentence Comprehension: Eye Movements in the Analysis of Structurally Ambiguous Sentences. Cognitive Psychology, 14(2):178–210, 1982. 在一项眼动研究中,阅读开头具有误导性的句子的读者会把目光移回前面的词,重新解析句子。
[3] Jakob Nielsen. F-Shaped Pattern for Reading Web Content (Original Study). Nielsen Norman Group, April 16, 2006. 该研究追踪了232名用户阅读数千个网页时的眼动。
[4] Jakob Nielsen. First 2 Words: A Signal for the Scanning Eye. Nielsen Norman Group, April 6, 2009.
[5] Lyn Frazier, Lori Taft, Tom Roeper, Charles Clifton, and Kate Ehrlich. Parallel Structure: A Source of Facilitation in Sentence Comprehension. Memory & Cognition, 12(5):421–430, 1984. 2010年,Sturt、Keller和Dubey发现,即使两个短语之间没有“and”连接,当后一个短语与前面的短语结构相同时,读者读起来也更快:Patrick Sturt, Frank Keller, and Amit Dubey. Syntactic Priming in Comprehension: Parallelism Effects with and without Coordination. Journal of Memory and Language, 62(4):333–351, 2010.
[6] 有趣的是,现代数据压缩算法的工作原理与此类似,利用重复模式。例如,gzip在模式第一次出现时存储它,之后每次出现都用指向它的短指针替换。因此,只有一个模式的列表对gzip和读者来说都易于压缩。
[7] 例如,ASD Simplified Technical English(航空维修手册的写作标准)的核心规则之一是“一个词,一个意思”。此外,Jakob Nielsen的第四条可用性启发式规则指出,用户“不应该需要猜测不同的词、情境或动作是否意味着相同的东西”。见Jakob Nielsen. 10 Usability Heuristics for User Interface Design. Nielsen Norman Group, 1994.
[8] 我们于2026年10月28日从ollama/ollama复制了10个公开issue,并添加了一个名为“Summary”的Notion AI自动填充属性,使用其默认设置。图3展示了issue #19359、#19342、#19375和#19340的摘要,未做改动。
[9] Perplexity Discover,访问于2026年10月28日。
[10] Jock Mackinlay. Automating the Design of Graphical Presentations of Relational Information. ACM Transactions on Graphics, 5(2):110–141, 1986.
[11] Jeff Heer. CSE 512: Data Visualization. University of Washington, Spring 2024. 参见关于数据和图像模型以及可视化设计的讲座。
[12] 我们于2026年10月28日从Apple的公开评论Feed下载了Duolingo在美国App Store的最新100条评论;这些评论来自2026年10月26日和27日。Claude对其运行了数据分析插件中的data:analyze技能,并写了11张主题卡片。图5展示了其中5张,未做改动。文本中的数字是我们提供的;插件没有报告这些数字。
[13] 经询问Claude后得知,存在相关的先前工作,我们尚未仔细阅读。例如,Kousta、Vinson和Vigliocco发现,人们识别情感词(无论正面还是负面)比识别中性词更快。见Stavroula-Thaleia Kousta, David P. Vinson, and Gabriella Vigliocco. Emotion Words, Regardless of Polarity, Have a Processing Advantage over Neutral Words. Cognition, 112(3):473–481, 2009.