
Perplexity决策模型每100次评估0.82美分,性能达OpenAI九成
决策模型(Decision Models)最近如雨后春笋般涌现,先是 TypeSafe 的 Jev,接着是 Perplexity 的 Decider、Liquid 的 d1、Cloudflare 的 Clef,以及 OpenAI 的 Decisions API[^1]。这些模型承诺提供快速、廉价的分类能力。
对于自动化评估(automated evals),决策模型是 LLM 评判器(LLM judge)[^2]之外一个有吸引力的低成本替代方案。但选择是否恰当,取决于你的用例对成本、性能和延迟的要求。
我们还注意到,很多人在使用决策模型时直接采用默认决策阈值 0.50,而没有检查这个阈值是否适合自己的任务。这可能会损失不少性能。
在本文中,我们将首先展示如何调优阈值,以便从决策模型中获得最佳结果。在阈值调优完成后,我们会比较成本和性能,帮助你评估哪种模型最适合你的用例。最后,我们将探讨在决定是否采取行动时如何解读模型得分,以及校准(calibration)如何让这些得分作为置信度估计更有用。
我们测试了什么
我们使用了来自公寓租赁代理的 100 条轨迹(traces),即对话和操作的日志。任务是识别包含错误的轨迹,例如预订失败或漏接人工交接[^3]。我们在之前关于自动化评估的文章中使用了相同的数据集和广义的故障查找任务。这里,每个决策模型都会为每条轨迹返回一个故障概率。
我们测试了 Jev 1.13、Perplexity Decider 1.1 27B、Liquid d1 和 d1-ultra、Cloudflare Clef Flash,以及 OpenAI Decisions(GPT-6 Luna)[^1]。每个模型都收到相同的评估标准。附录展示了提示词以及用于 Jev 的结构化版本。
我们在两个维度上比较模型:
- 性能:我们将每个模型的预测与人工审阅并标记为通过或失败的轨迹进行比较。这衡量模型在避免误报的同时捕捉失败的能力。
- 成本:我们根据 token 使用量和提供商的定价计算 API 成本[^4]。
为简洁起见,我们不讨论延迟,因为它取决于本实验控制之外的因素[^5]。
理解决策阈值
我们为每条轨迹分配两个标签之一:通过或失败。这是二元的通过/失败评估,我们推荐这样做,因为它鼓励明确的标准,并且更容易与人类偏好对齐。
每个决策模型返回一个 0 到 1 之间的分数,用于估计轨迹包含失败的可能性。API 使用默认决策阈值 0.50 将这个分数转换为决策。分数达到或超过阈值的轨迹被标记为失败。如果不根据你的数据检查就使用默认阈值,可能会得到不佳的结果。
例如,一个模型可能给所有失败赋予 0.40 分,给所有通过轨迹赋予 0.10 分。即使这个模型在 0.30 阈值下能完美分类轨迹,默认的 0.50 阈值也会什么也捕捉不到。
在实践中,失败轨迹和通过轨迹的分数会重叠。降低阈值能捕捉更多失败,但也可能带来更多误报。选择阈值意味着权衡:
- 精确率(Precision):被标记的轨迹中确实包含已知失败的比例。
- 召回率(Recall):模型捕捉到的已知失败占全部已知失败的比例。
正确的权衡取决于你的业务目标。例如,刑事审判设定很高的定罪标准以避免冤枉无辜,强调精确率。癌症筛查可能强调召回率,接受更多误报以减少漏诊[^6]。在本比较中,我们使用 F1 分数(精确率和召回率的调和平均数)给予两者相同权重。F1 取值范围为 0 到 1,越高越好。
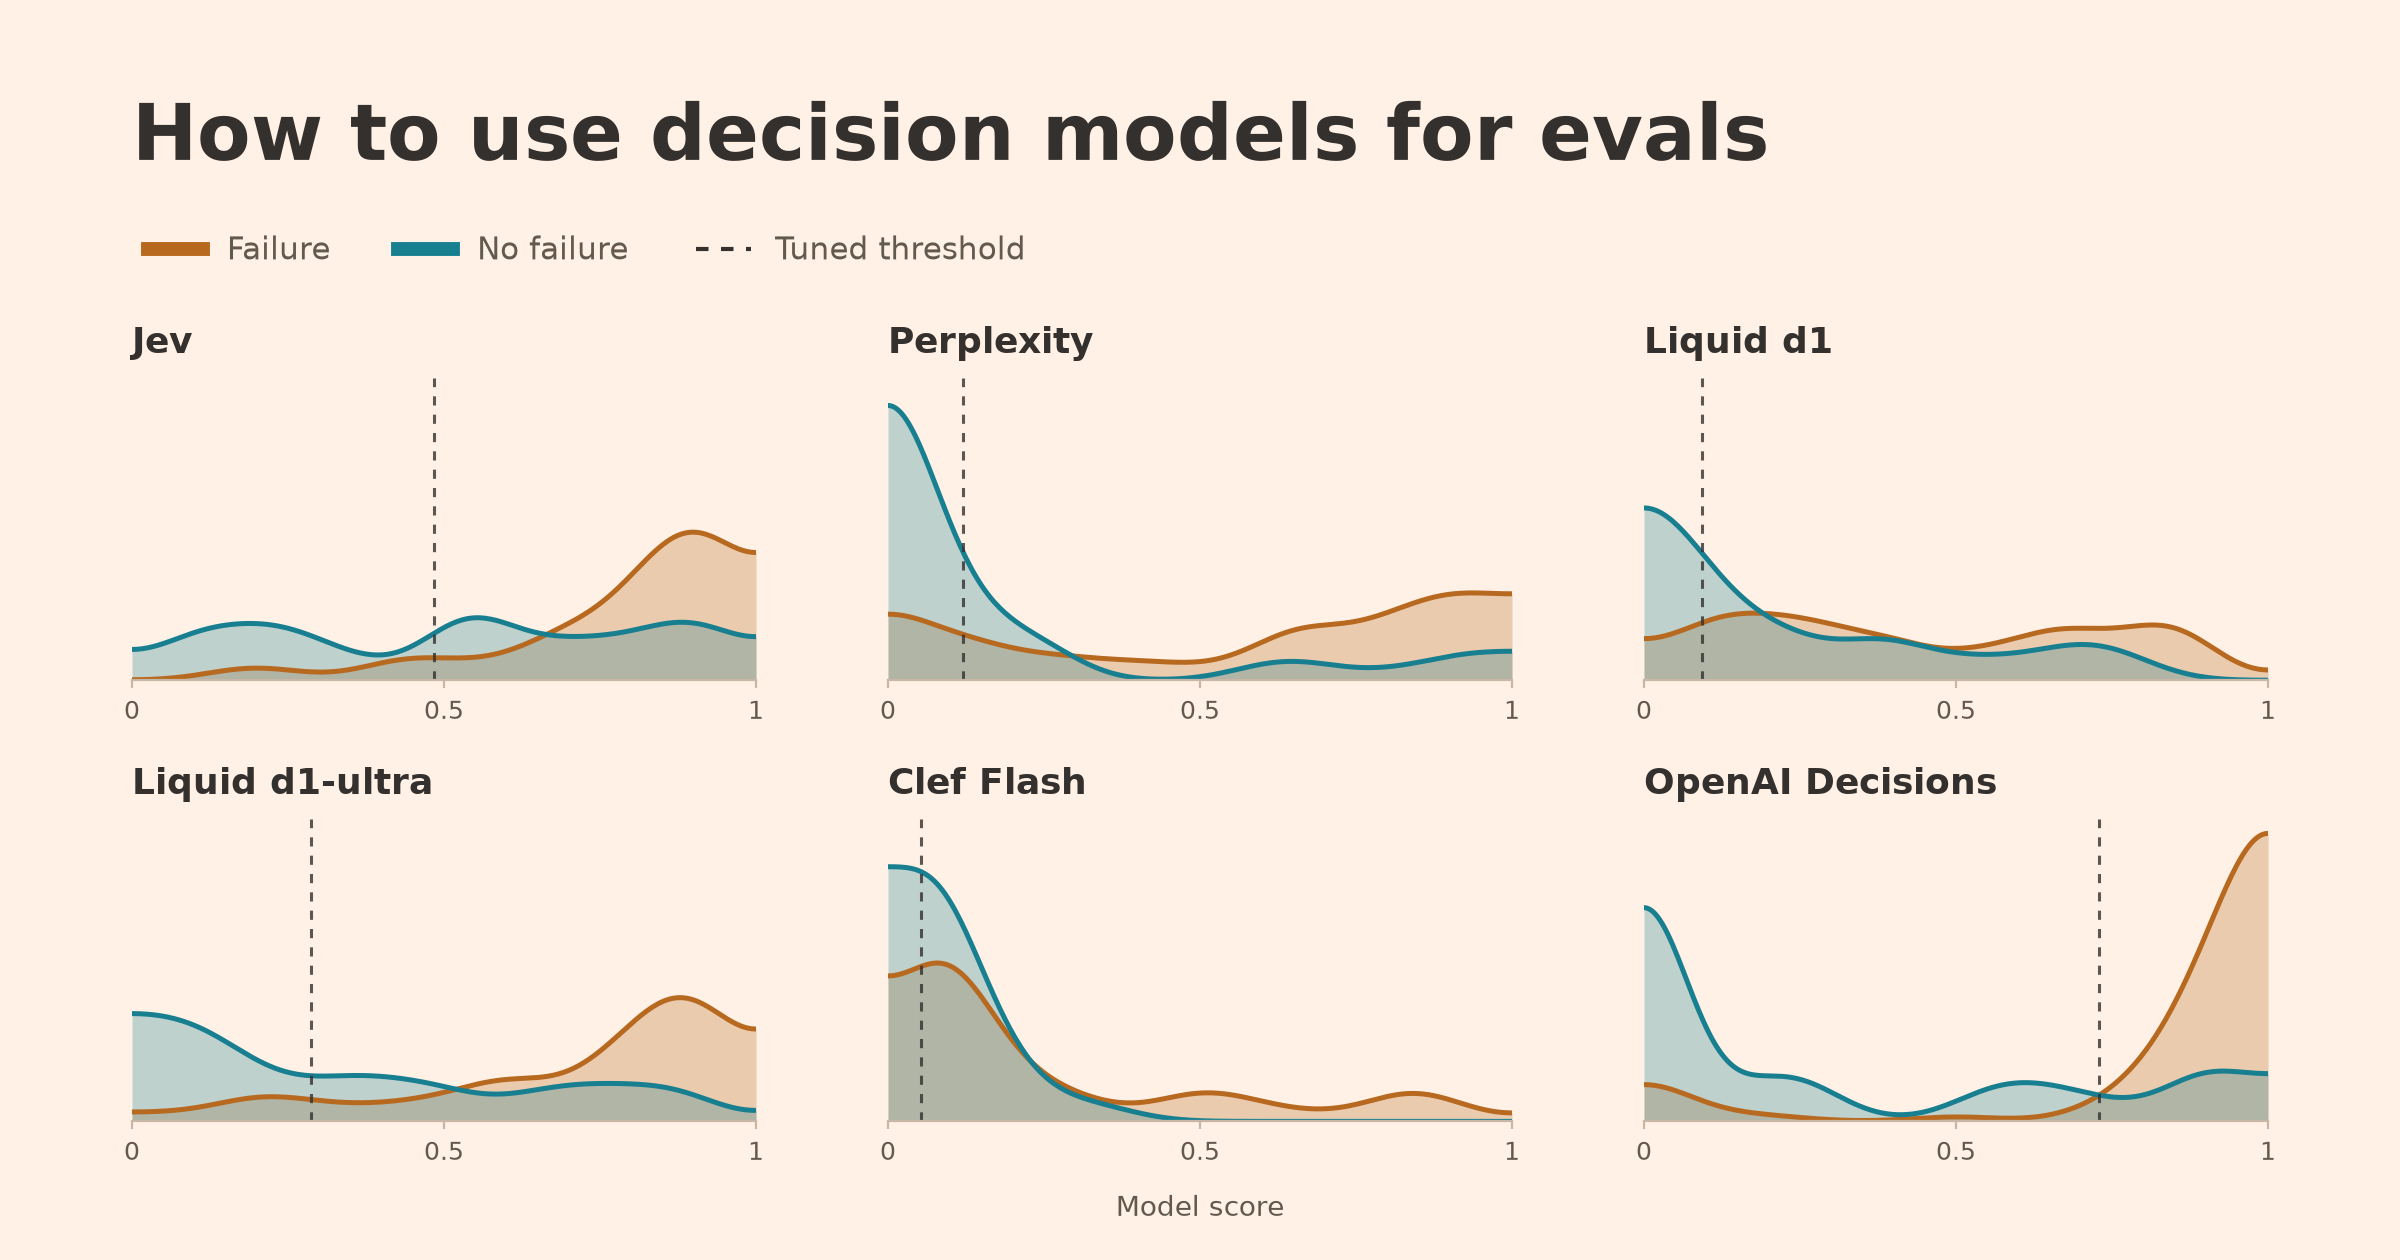
下面的曲线展示了每个模型如何给失败(橙色)和通过(蓝色)的轨迹打分。曲线更高的部分意味着该类别有更多分数落在这个区间。达到或超过虚线阈值的分数会被标记。使用切换按钮对比 0.50 与针对最佳 F1 优化后的阈值(后者为每个模型选择一个阈值)[^7]。
在这个任务上,OpenAI 对两个类别的区分最好,这也反映在它更高的 F1 分数上。
同样重要的是,不要盲目最大化 F1 而不考虑分类器有用所需的最低要求。例如,如果这个分类器用于自动化预警系统,我会希望精确率和召回率都至少达到 80%,以便在捕捉足够多失败的同时尽量减少误报。
下图展示了精确率和召回率在不同阈值下的变化[^8]。阴影区域标记了两者都达到至少 80% 的范围。
Perplexity、Liquid d1-ultra 和 OpenAI Decisions 满足我们的要求,但我们仍然需要为每个模型在阴影区域内选择一个决策阈值。在下一节中,我们将讨论如何调优这些阈值。
调优决策阈值
在本例中,我们将优化 F1。对于候选模型,只要可能,我们会将调优限制在训练数据上满足 80% 最低要求的阈值。其他模型不设约束,以便展示调优的效果[^9]。
有了标记的轨迹和保存的模型分数,你可以让编码代理(coding agent)来调优阈值。下面是一个示例提示词,你可以根据自己的用例修改:
> 使用我保存的模型分数和二元标签(1 表示失败),调优决策阈值以最大化 F1,同时要求精确率至少 80%,召回率至少 80%。使用分层五折交叉验证,在训练样本上选择阈值,并在剩余样本上衡量性能。如果比较多个模型,请为每个模型使用相同的划分。只选择在训练样本上满足两个最低要求的阈值。如果没有符合条件的阈值,请报告这一情况,而不要放宽任何要求。报告验证集上的精确率、召回率和 F1,以及任何没有合格阈值或验证性能低于我最低要求的划分。与默认阈值 0.50 进行对比。复用已保存的分数,不要发起新的模型调用。
下面是针对 F1 的调优如何改变每个模型的性能。我们将精确率-召回率图中三个候选模型放在一起,用灰色显示其他模型,以说明调优能带来多大帮助。
我们的候选模型从 F1 调优中获得的收益不如低于我们最低要求的 Liquid d1 和 Clef Flash。然而,即使精确率和召回率的微小变化也会影响业务成本或用户体验,所以要慎重选择权衡。在实践中,精确率和召回率不太可能同等重要(正如本文通过 F1 所假设的那样)。例如,F-beta 分数允许你通过将 beta 设为小于 1 来赋予精确率更多权重,或设为大于 1 来赋予召回率更多权重。优化不同的指标可能会导致不同的阈值和结果。
性能与成本对比
下图比较了每个模型(调优后)的 F1 与成本,聚焦于我们剩余的候选模型:
虚线显示我们剩余候选模型中的帕累托前沿(Pareto frontier)。对于任何给定的 F1 分数,它标识出达到或超过该分数的最便宜候选。这个特定的图表有点简单,因为只有三个选项,但它很好地说明了如何思考成本与性能。
在候选模型中,Perplexity 是最便宜的,每 100 次评估运行 0.82 美分,F1 为 0.79。OpenAI Decisions 每 100 次评估运行 3.72 美分,F1 达到 0.87,成本约为前者的 4.5 倍。
我们能相信这些概率吗?
除了通过/失败评估之外,你可能想将决策模型的分数用作置信度估计。但你能按字面意义理解这个数字吗?要让 0.80 的分数意味着 80% 的失败概率,大约 80% 的具有相近分数的轨迹应该包含失败。
下图展示了每个模型的概率校准情况:预测概率与观察到的结果有多接近[^10]。每个点代表大约 20 条具有相似分数的轨迹。对角线上的点意味着预测概率与该组的失败率相符。线以上的点表示模型低估了失败风险。线以下的点表示模型高估了该风险。
如果预测概率与观察到的结果不匹配,我们可以使用另一个模型来调整它们。第二张面板展示了一种方法:Platt 缩放(Platt scaling),它拟合一条简单的曲线来进行调整[^11]。
Perplexity、Liquid d1 和 Clef Flash 在校准后更接近对角线。例如,一组 Clef Flash 轨迹的平均预测失败概率约为 8%,但其中 60% 包含了失败。
Jev 和 Liquid d1-ultra 在这个数据集上已经校准得很好,几乎不需要调整。
Platt 缩放并不总是最合适的。例如,OpenAI 的概率在我们使用的 Platt 缩放版本下略有变差[^12]。你可以指示编码代理使用下面的提示词进行校准:
> 使用我保存的失败概率和二元标签(1 表示失败),测试 Platt 缩放是否能改善每个模型的概率。使用分层五折交叉验证,每个模型使用相同的划分。在每个训练划分上拟合校准映射,并应用到剩余的轨迹上。对 log-odds 拟合,先将概率从 0 和 1 处截断。在校准前后绘制预测概率与观察到的失败率的关系图。报告 Brier 分数(越低越好),并说明哪些模型变好了或变差了。复用已保存的分数,不要发起新的模型调用。
提示词调优与评估器范围
我们在本文中保持了宽泛的评估任务,以便更容易地看到模型之间的差异。在实践中,我们建议为每种失败模式构建一个独立的评判器。任务更聚焦、指导更具体时,模型之间的性能差距预计会缩小。
我喜欢先从在任务上表现可接受的大型模型开始,然后尝试较小的模型,看看它们能否以更低的成本匹配较大模型的性能。如果你有高质量的标签,提示词调优也会很有帮助[^13]。我在另一篇文章中讨论了如何编写好的评判器提示词。
将这些想法付诸实践
对于这个特定的数据集,OpenAI 在更高成本下表现出突破性的性能。Perplexity 和 Liquid d1-ultra 提供了成本更低、性能也较低的选项。我们观察到模型性能在不同任务和数据集之间差异很大,这意味着自己动手衡量是很重要的。
回顾一下要点:
1. 一旦你对评判器的提示词感到满意,为你的用例设定最低精确率和召回率要求。排除无法满足这些要求的模型。
2. 在比较性能之前,先调优每个模型的决策阈值。选择适合你业务目标的精确率-召回率权衡。要有意为之,不要因为本文用了 F1 就用 F1!
3. 如果你想将分数用作置信度估计,检查概率是否与观察到的结果相符。校准可能有帮助,但你需要衡量它是否真的有所改善。
4. 针对你的工作负载权衡性能、成本和延迟。
这个过程是迭代的。你可能改进了提示词,然后需要再次调优阈值或重新审视校准。在本文中,我们专注于阈值调优和校准,因为我们看到很多人不经考虑就直接使用决策模型。
你可能还想知道决策模型与 LLM 相比如何。OpenAI Decisions 使用 GPT-6 Luna,它以最高成本实现了我们最高的 F1,这表明更难的评估任务可能值得为 LLM 支付更多费用。在更广泛的比较中,Randy Olson 发现决策模型在分类和路由任务上能以更低的成本匹敌 LLM,而 LLM 在需要知识和推理的任务上更胜一筹。
本文讨论的所有想法都不是新东西。选择精确率-召回率权衡、调优阈值和比较性能与成本,是评估任何分类器的一部分。想了解更多基础,我推荐 Kyle Gallatin 和 Chris Albon 的《Machine Learning with Python Cookbook》第二版。
最后,如果你是一位数据科学家或机器学习工程师,想知道自己在 AI 时代的位置,这些技能你已经具备了。是时候“复仇”了 🙂。
附录:评估提示词
Perplexity、Liquid d1 和 d1-ultra、Clef Flash 和 OpenAI Decisions 收到以下提示词。Jev 收到了等效标准的结构化提示词,见下面的示例。图表中使用的分数和标签以 JSON 格式提供。
> 判断 messages 中是否至少存在一个 AI 助手行为或工具使用方面的实质性失败、风险或质量问题。这是来自一个通过电话或消息处理公寓租赁客户支持的 AI 的完整生产轨迹。轨迹包含对话以及所有工具调用和工具输出。
>
> 评估 AI 助手及其工具使用,而不是客户。将 messages 内的系统消息视为管理助手行为和允许能力范围的指令。检查完整的轨迹,包括最后的回合以及所有工具调用和输出。仅基于此轨迹中可见的证据做出判断。不要假设外部政策、渠道行为或业务需求。不要假设每条轨迹都失败了。一条简短、模糊或无法得出结论的轨迹本身不是问题,除非可见证据确立了实质性问题。
>
> 返回至少存在一个实质性问题的概率;不需要给出问题的名称或类别。
>
> 在轨迹支持的情况下,以下情况算作问题:助手违反了适用的系统指令或工具结果;做出无根据的事实或操作声明;遗漏、误用、重复或虚假声称完成了所需的工具操作、转接、预订、取消、后续跟进或确认;实质上误解或未解决用户的明确请求;或向客户暴露了内部操作、占位符或损坏内容,从而实质性损害了交互。
>
> 以下情况不算问题:没有实质性影响的轻微风格偏好;仅由客户行为导致的失败;未暴露给客户且未导致错误响应的内部工具元数据;需要轨迹之外信息的假设性担忧;以及证据不足或无法得出结论的对话。
示例:结构化提示词
下面是我们为 Jev 的请求构建提示词的方式,将指令和评估标准放在单独的字段中。
{
  "version": "nurtureboss-any-issue-v1",
  "question_id": "has_substantive_issue",
  "type": "noul",
  "instructions": {
    "task": "Does `messages` contain at least one substantive failure, risk, or quality problem in the AI assistant's behavior or tool use?",
    "context": "This is one production trace from an AI that handles apartment-leasing customer support over phone or messaging. The trace contains the complete conversation plus any tool calls and tool outputs.",
    "evaluation_rules": [
      "Evaluate the AI assistant and its tool use, not the customer.",
      "Treat system messages inside `messages` as the instructions governing the assistant's behavior and allowed capabilities.",
      "Inspect the full trace, including the final turns and all tool calls and outputs.",
      "Base the judgment only on evidence visible in this trace. Do not assume external policies, channel behavior, or business requirements that are not present.",
      "Do not assume every trace failed. A short, ambiguous, or inconclusive trace is not an issue unless the visible evidence establishes a substantive failure.",
      "Return the probability that at least one substantive issue is present. The issue does not need to be named or clustered."
    ]
  },
  "criteria": {
    "true": {
      "definition": "At least one substantive problem is supported by evidence in the trace.",
      "examples_of_qualifying_evidence": [
        "The assistant contradicts an applicable system instruction or a tool result.",
        "The assistant makes an unsupported factual or operational claim.",
        "A required tool action, transfer, booking, cancellation, follow-up, or confirmation is missing, incorrect, repeated, or falsely claimed as complete.",
        "The assistant materially misunderstands or leaves an explicit user request unresolved.",
        "Customer-facing text exposes internal actions, placeholders, or broken content that materially harms the interaction."
      ]
    },
    "false": {
      "definition": "No substantive assistant problem can be established from the visible trace.",
      "do_not_count_as_an_issue": [
        "A minor stylistic preference with no meaningful effect.",
        "A failure caused only by the customer's behavior.",
        "Internal tool metadata that was not exposed to the customer and did not cause an incorrect response.",
        "A hypothetical concern that requires information outside the trace.",
        "Insufficient evidence or an inconclusive conversation."
      ]
    }
  }
}
脚注
[^1]: 测试的版本:Jev 1.13(2026 年 9 月 15 日发布)、Perplexity Decider 1.1 27B、Liquid d1 和 d1-ultra、Cloudflare Clef Flash 和 OpenAI Decisions。OpenAI Decisions 使用 GPT-6 Luna。API 返回类型化答案,包括针对真/假问题的 0 到 1 概率。这是一个独立的 API,不同于 Structured Outputs(后者生成匹配自定义 JSON schema 的响应)。我们包含它是因为它服务于相同的分类任务。↩
[^2]: LLM 评判器使用提示词来评估 AI 系统的输出或行为。我们建议让它针对特定失败模式做二元的通过/失败判定。这鼓励明确的标准,并使评判器的决策更容易与人工标签比较。↩
[^3]: 我们在 100 条轨迹数据集中排除了两个内部 QA 示例后,对 98 条生产轨迹进行了评分。冻结参考包含 61 个已知失败和 37 条没有标记失败的轨迹:39 个来自原始人工审查的失败,加上来自 Braintrust 和 Arize 的 22 个经我们手动验证的发现。模型收到的是屏蔽过的轨迹,没有人标签或审查者备注。Perplexity、Liquid、Clef Flash 和 OpenAI 收到相同的指令和序列化输入;Jev 通过其结构化 API 收到等效标准。原始对话是私有的。↩
[^4]: API 成本涵盖 100 次评估运行(每条轨迹一次)。我们使用 Liquid 截至 2026 年 10 月 17 日的定价:d1 每百万输入 token 0.02 美元,d1-ultra 为 0.042 美元。实验记录了 d1 为 0.04 美元;我们对其保存的 token 使用量重新定价。其他模型使用实验操作指标中的费率。性能排除两条内部 QA 轨迹。阈值调优使用已保存的分数,不产生额外的模型调用。↩
[^5]: 延迟取决于你如何批处理或并行化请求、与供应商的安排、与基础设施的距离等因素。批处理和并发也会改变成本和吞吐量。参见 TypeSafe 的多问题请求和客户端性能指南。其发布讨论还提到了延迟测试相对服务的位置。平均响应时间:Jev 4.33 秒、Perplexity 7.85 秒、Liquid d1 7.38 秒、Liquid d1-ultra 1.56 秒、Clef Flash 2.09 秒、OpenAI 2.77 秒。这些来自不同的运行,不能确立比较性的吞吐量或尾部延迟。↩
[^6]: 这些例子说明了错误的后果如何影响权衡。在美国刑事审判中,排除合理怀疑为定罪设定了很高的标准。在癌症筛查中,漏诊可能延误治疗,而误报可能导致焦虑和不必要的程序。阳性筛查结果通常需要进一步检查。NCI 解释了这两种风险;适当的平衡取决于筛查测试和人群。↩
[^7]: 密度图显示无约束的 F1 调优,在引入最低精确率和召回率要求之前。后面的比较图表在可行的情况下对候选模型应用这些要求。所有图表使用相同的五折交叉验证划分。阈值在训练轨迹上选择,精确率、召回率和 F1 在分离的轨迹上衡量。我们跨重复划分平均这些测量结果。在优化密度图中,虚线显示平均选择的阈值。显示的分数来自各个划分,而不是将该平均阈值应用于完整数据集。密度曲线使用带宽 0.07 的高斯平滑,并在 0 和 1 处反射。每个类别的面积为 1。平滑仅影响显示。↩
[^8]: 精确率-召回率曲线绘制了精确率随决策阈值变化对应的召回率。它展示了模型在不同阈值下的可用权衡。Scikit-learn 的精确率-召回率指南解释了如何阅读和绘制这些曲线。↩
[^9]: 我们从全样本精确率-召回率曲线中识别候选模型。在每个训练划分中,我们在达到至少 80% 精确率和 80% 召回率的阈值中选择 F1 最高的阈值。当没有阈值符合条件时,我们使用无约束的 F1 最优,并记录该划分为不可行。Perplexity 在 100 个训练划分中有 36 个出现这种情况,Liquid d1-ultra 有 29 个,OpenAI 从未出现。非候选模型始终使用无约束的 F1 调优。我们保留所有验证预测(包括来自回退划分的预测)在报告的平均值中。最低要求适用于选择过程,不保证在新示例上也有相同表现。阈值选择审计记录每个划分但不记录轨迹 ID。↩
[^10]: 校准后的 0.80 失败概率意味着,在许多得分接近 0.80 的示例中,大约 80% 包含失败。Platt 缩放和等渗回归使用带标签的示例来学习从模型分数到概率的调整。Platt 缩放拟合 S 形曲线。等渗回归拟合更灵活的映射,保持分数顺序,但更容易在小数据集上过拟合。两者都不能保证在新示例上的改进。Scikit-learn 的概率校准指南解释了这两种方法以及如何评估它们。↩
[^11]: 可靠性图表按概率排序将每个模型的分数分成五组,每组 19 或 20 条轨迹。调整后的分数是每条轨迹从保存的交叉验证结果中得到的折叠外平均概率。我们对原始概率的 log-odds 拟合 Platt 缩放。每个映射在不预测的轨迹上拟合。图表总结了这个较小的样本,并不能确定未来轨迹的精确失败率。绘制的校准结果以 JSON 格式提供。↩
[^12]: 在已保存的折叠外概率摘要上,Jev 的 Brier 分数在校准前是 0.187,之后是 0.188。Liquid d1-ultra 分别是 0.173 和 0.172,而 OpenAI 是 0.159 和 0.164。Brier 分数衡量平均平方概率误差,越低越好。它同时反映判别力和校准度。这些结果描述的是图表中展示的 log-odds Platt 拟合。一个直接对概率进行的探索性重拟合(使用相同的折叠)给 OpenAI 带来 0.154 的 Brier 分数。这说明对拟合方法的敏感性。它不能确定哪种方法在新数据上效果最好。↩
[^13]: GEPA 使用模型运行的反馈来提出提示词修订,并针对带标签的示例进行测试。它保留具有不同优势的候选提示词,因此对困难示例有帮助的提示词可以留在考虑范围内。错误的标签可能会把这个搜索引向错误的改动。将测试集与提示词开发分开,保留用于最终检查。在我们的小型手动 Jev 实验中,默认阈值下的 F1 从简单提示词的 0.78 上升到带有失败类型清单的提示词的 0.80。该实验没有使用 GEPA,也没有确立系统优化能有多大的帮助。我们关于选择评估模型的常见问题解答讨论了提示词优化和模型比较。↩