
Qwen3.8实测:温度调低写代码更差,科学问答几乎无差
语言模型的温度参数控制单词选择的随机性。调得越低,模型越倾向选最可能的词。调到0,就是每一步都选概率最高的那个,叫贪婪解码。
一位技术作者拿 Qwen3.8 27b 做了组对照。模型量化到 IQ4_XS-M 格式,约4.6bpw。引擎是 llamAmpere v0.5.2,推理努力度设为 medium。top_p 0.95、top_k 20、min_p 0 固定。只改温度,测了0、0.25、0.5、0.75、1.0五档。0.25到1.0各跑三次不同种子。0只跑一次,贪婪解码每次结果相同。
编码测试是 LiveCodeBench v6,100道最新竞赛的难题。程序要通过全部隐藏测试才算过关。温度一档档抬,成绩整体往上走。0时70.0%,0.25和0.5都是76.0%,0.75是79.7%,1.0是82.7%。0和0.25与1.0的差距在统计上显著。0.5和0.75单独拆开不显著,合在一起显著。换成题数:同样的100道题,1.0能过83道,0只能过70道,差了13道。
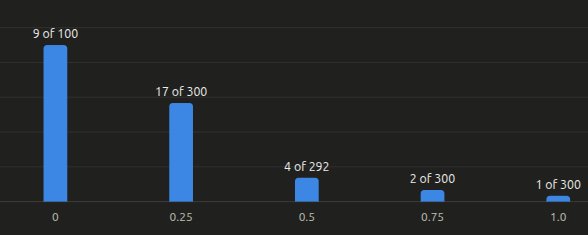
差距主要出在循环。温度越低,模型越容易反复重复同一段话,直到顶满100,000令牌上限。请求一旦触顶就失败。0时有9/100个编码请求陷进去,0.25时17/300,1.0时只有1/300。所有触顶请求都算失败。常见解释是:随机性太低,没有东西能把模型从重复模式里推出来;温度稍高一点,模型偶尔选到不同的词,循环就断了。
循环不是全部原因。作者说性能下降“大部分但并非完全”由循环导致。低温还让回答变长。编码平均答案在0时用45,533个令牌,1.0时用37,191个,多了八千多个令牌。等待和解码时间随之变长,计算成本更高。
科学知识问答是另一回事。GPQA Diamond有198道研究生水平单选题,各温度得分都在81%到83%之间。作者另外评了100道“困难切片”题。低温让科学答案也变长5%到8%,但作者说这个范围只是提示性,不能下结论。
作者还做过一个对比。此前发布的2.3bpw量化版 Qwen3.8 27b,在 LiveCodeBench 上约77%。这次4.5bpw的模型在贪婪解码下只有70%。就算加上中等与extra high之间预估的7点差距,也只有77%。这和一个只有它一半大小的模型打平。
硬件条件并不完全统一。测试用租来的NVIDIA显卡,RTX A6000、RTX 6000 Ada、RTX PRO 6000三种混用。作者额外比较了同一显卡上的配对,0和0.25的结果仍然显著。另一个检查对0.5给出p=0.018,但那是主分析之后才加的,所以0.5仍按不显著算。
样本量能撑住的差异有上限。总共计划3874个答案,实际评了3866个(99.8%)。缺的8个全在一次编码运行里:温度0.5、种子1那次只评了92/100,毁于基础设施错误。作者用bootstrap重采样10000次估95%范围。做了12次配对比较,没做多重比较校正,边缘结果可能是碰巧。按样本量算,科学测试能察觉到3到6点的差异,编码测试6到12点。更小的差异可能发生,只是这次测不出来。温度1.0的三次编码得分是85、84、79,单次运行就能波动几分。
低温为什么会引发循环,现在还没有定论。作者提到,有人用dflash或MTP时把温度压到极低,想提升每秒token数。这个做法适得其反——低温真正放大的主要是冗长。他正在计划更吃算力的测试,看中等温度和接近1的温度对27b模型是否更合适。理想情况是编码应用能跑在0.75到0.9,这样推测解码可以更快。极低温度的结论已经清楚:不要用。
关键事实
- 低温度(0或0.25)不会损害混合模型(Qwen3.8 27b)在事实性测验中的表现。
- 低温度使Qwen3.8 27b在编码任务上显著变差。
- 测试模型为Qwen3.8,压缩至IQ4_XS-M格式,约4.6bpw(每权重比特数)。
- 引擎为llamAmpere v0.5.2,使用其发布的24GB显卡设置,推理努力度设为“medium”。
- 测试温度包括0, 0.25, 0.5, 0.75和1.0。
- 编码测试使用LiveCodeBench v6,100道最新竞赛中的难题,程序必须通过所有隐藏测试才算通过。
- 编码准确率随温度升高而显著上升:0时为70.0%,0.25时为76.0%,0.5时为76.0%,0.75时为79.7%,1.0时为82.7%。