
系统设计精要最终篇:五种缓存策略与四种限流算法
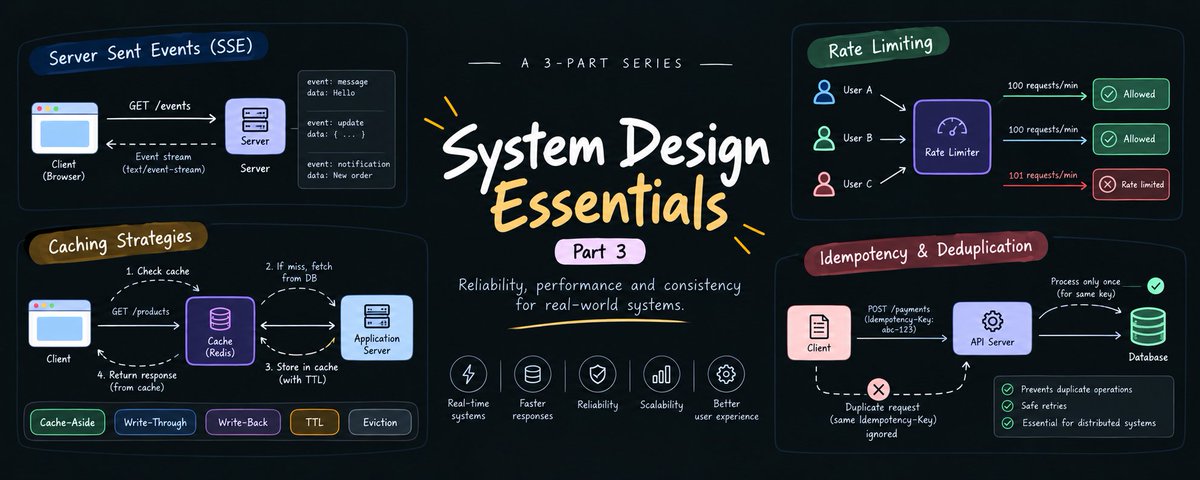
设计一个高度可扩展且高效的系统,当你掌握所有核心构建块并知道如何使用它们时,就会变得容易。本篇是「系统设计精要」系列的第三部分,也是最后一部分,重点聚焦缓存(Caching)和限流(Rate Limiting)算法等优化技术。
41. 缓存(Caching)
缓存是将频繁访问的数据存储在快速存储层中的过程,这样在提供数据时就不必反复查询主数据库。
原本的方式:
客户端(浏览器)→ 产品服务 → 数据库
优化后:
客户端(浏览器)→ 产品服务 → 检查缓存 → 如果命中(Cache Hit)→ 直接返回数据;无需查询数据库
- 缓存命中(Cache Hit):请求的数据已存在于缓存中,服务立即返回,不查询数据库。
- 缓存未命中(Cache Miss):数据不在缓存中,服务必须从数据库获取。
- 缓存失效(Cache Invalidation):如果缓存数据已过期,则使其失效。
缓存的优点:
- 更快的响应时间
- 降低数据库负载
- 降低基础设施成本
- 更好的可扩展性
42. 缓存策略 - Cache Aside(旁路缓存)
在这种策略中,服务端负责管理缓存。客户端发送请求给服务端,服务端先查询缓存。如果请求的数据在缓存中,就是 CACHE HIT,直接返回,不需要查数据库。如果没有找到,就是 CACHE MISS,服务端从数据库返回数据并更新缓存。
43. 缓存策略 - Read Through(读穿透)
在这种策略中,缓存位于服务端和数据库之间。服务端从不直接查询数据库,而是由缓存保持自身数据更新。当发生缓存未命中时,缓存会负责从数据库加载数据并写入,后续读取直接命中。
44. 缓存策略 - Write Through(写穿透)
在这种策略中,每次写入/更新操作都先写缓存,再写数据库。这能保证缓存与数据库的一致性,但写入延迟会略高。
45. 缓存策略 - Write Around(绕写)
在这种策略中,每次写入都直接写数据库,服务端只在发生缓存未命中时才更新缓存。这种策略避免了缓存被写入后又很少读取的数据污染。
46. 缓存策略 - Write Back(回写)
在这种策略中,每次写入都先写缓存,然后由缓存定期把所有操作批量更新到数据库。写入性能高,但如果缓存节点故障,可能会丢失尚未持久化的数据。
47. 幂等性(Idempotency)
幂等性意味着对同一操作执行多次,结果与执行一次相同。这在分布式系统中非常重要,因为网络故障、超时或重复消息会不断触发重试。一个操作如果重复执行产生相同结果,它就是幂等的。GET、PUT、DELETE 天然幂等,但 POST 通常不幂等,因为每次调用都会创建新内容。
示例:支付请求在响应到达客户端之前超时。客户端认为失败并重试,但服务端其实已经处理过第一次请求。如果没有幂等性,用户会被扣两次款。
在具有多个消费者和提供者的分布式系统架构中,幂等性至关重要,因为生产者可能多次投递同一个事件。
48. 幂等性键(Idempotency Key)
幂等性键是客户端生成并与请求一起发送的唯一值,让服务端能够识别同一操作的重试。服务端会存储已经处理过的键,如果相同键再次到达,就返回原始结果,而不是重复执行动作。这就是让 POST 这类操作可以被安全重试的真正机制。
49. 去重(Deduplication)
去重会检测并丢弃相同消息或事件的重复副本,使其只被处理一次。这在消息队列和事件流等系统中尤为重要,因为这类系统通常保证「至少一次投递」,意味着同一条消息可能到达多次。常见方法是为每个消息维护唯一 ID,并跳过已经见过的 ID。
示例:一个支付事件被发布到队列,但由于网络抖动被投递了两次。消费端根据消息 ID 对照已处理记录,识别出重复并跳过,而不是再次处理支付。
去重和幂等性从不同角度解决类似问题。去重发生在发送方或基础设施侧,在消息被处理之前检测并丢弃重复。幂等性发生在接收方业务逻辑中,设计目标是即使重复消息漏过并被处理,最终结果仍然一致。系统通常同时使用两者:去重在早期捕获大多数重复,幂等性作为安全网兜住漏网之鱼。
50. 分布式系统(Distributed Systems)
分布式系统是一组独立机器的集合,它们协同工作,对用户表现为一个单一系统,即使工作实际上分散在多台计算机上。当你添加第二台服务器、副本或独立数据库时,你就拥有了分布式系统,无论你是否刻意设计。
为什么需要分布式系统?
单台机器会有存储、计算和流量处理能力的上限。分布式系统架构打破了这种限制。你的应用现在可以扩展,即使某台服务器宕机也不会整体失效。
分布式系统的挑战:
- 一致性(Consistency)
- 可用性(Availability)
- 容错性(Fault Tolerance)
- 延迟(Latency)
51. 一致性哈希(Consistent Hashing)
在分布式系统中,一致性哈希是一种常见的决定哪个服务器处理请求的方式。
简单做法是 hash(requestKey) % numberOfServers。这在服务器数量不变时有效。
- 5 台服务器:hash(request) % 5
- 移除一台后变为:hash(request) % 4
由于取模运算变了,几乎所有请求都会映射到与之前不同的服务器。只是因为移除一台服务器,几乎全部请求都被重新分配。
一致性哈希如何解决?
服务器和请求都通过哈希函数放在一个环上。每个请求被哈希到环上的某个位置,并由其顺时针方向下一个服务器处理。
请求到达 -> 哈希函数 -> 落在环上的位置 -> 顺时针映射到最近的服务器
移除服务器时:
只有原本由该服务器处理的请求会被重新映射到顺时针下一台服务器。其他服务器继续处理原有请求。
示例:移除服务器 B 后,原来映射到 B 的请求现在映射到顺时针下一台的 C;A、D、E 完全不受影响。
同样的原理也适用于数据库分片:分片放在环上而不是服务器上,移除一个分片时,只有该分片与其相邻分片之间的数据需要移动。
52. 向量数据库(Vector Database)
传统数据库做精确匹配。SQL 查询如 WHERE name = 'Anurag',要么匹配,要么不匹配。但如果你想找语义相似而不是值完全相同的东西呢?比如搜索「山的图片」。传统数据库做不到,向量数据库可以。
向量数据库专门以向量的形式存储和搜索数据。向量是由 AI 模型生成的一组数字,代表数据的语义。语义相似的内容会生成相似的向量,在数值空间中彼此靠近。这些向量称为嵌入(Embeddings),是把文本、图像和其他数据经过嵌入模型生成的。
常见应用场景:
- 语义搜索(Semantic Search)
- 推荐系统(Recommendation Systems)
- RAG 流水线(RAG Pipelines)
- 图像与音频搜索(Image and Audio Search)
53. 限流(Rate Limiting)
限流是一种用来控制客户端在给定时间窗口内向服务器发送请求数量的技术。它的主要目标是保护服务免受滥用,并确保公平使用。
假设你在构建一个 AI API,每生成一次响应都很昂贵。如果没有限流,恶意客户端可能每秒发送数千个请求,造成:
- 服务器过载
- 基础设施成本上升
- 合法用户响应变慢
- 拒绝服务攻击(DoS)
限流通过限制客户端可发出的请求数量来解决这个问题。
例如:
GET /api/chat
限制:100 次/分钟
如果客户端超过限制,服务器会返回:
HTTP/1.1 429 Too Many Requests
限流可以按以下维度执行:
- 按用户
- 按 API Key
- 按 IP 地址
- 按组织
- 按接口/端点
实现限流有多种算法:
54. 限流算法:固定窗口(Fixed Window)
时间线被划分为固定时间窗口(例如 12:00 到 12:01、12:01 到 12:02 这样的 1 分钟块)。一个简单计数器跟踪该窗口内的请求数。如果限制是 100 次/分钟,计数器会在每个新分钟开始时重置为 0。
要点:
- 最简单、最容易实现
- 允许窗口末尾出现请求突发
55. 限流算法:滑动窗口(Sliding Window)
这个算法不再使用固定窗口,而是存储每个请求的时间戳,并总是检查最近 N 秒内的请求数。
要点:
- 解决了固定窗口的请求突发问题
- 占用内存
56. 限流算法:令牌桶(Token Bucket)
客户端以固定速率获得令牌,每个请求消耗一个令牌。桶以固定速率填充令牌。它允许短时间突发流量,同时仍强制平均请求速率。
要点:
- 能处理请求突发
- 实现较复杂
57. 限流算法:漏桶(Leaky Bucket)
请求被送入一个队列,队列以恒定速率漏出请求。无论客户端发来多频繁的请求,服务器始终以固定速率接收请求。
要点:
- 服务器接收恒定负载
- 在突发期间会拒绝请求
58. 域名系统(Domain Name System)
计算机之间使用 IP 地址通信,而不是名称。例如 twitter.com 对人来说容易理解,但计算机不理解。计算机理解 143.250.183.46 这样的数字,也就是 IP 地址。
域名系统是一个分布式目录,将人类可读的域名映射到 IP 地址。
twitter.com → 142.250.183.46
一次域名解析过程:
1. 浏览器检查自己的缓存;最近是否查过这个域名
2. 操作系统检查它的缓存
3. 请求发往 DNS 解析器,通常由你的 ISP(互联网服务提供商)运行
4. 解析器询问根服务器,根服务器指向正确的 TLD 服务器
5. TLD 服务器(如 .com)指向该域名的权威服务器
6. 权威服务器返回真实 IP 地址
7. 解析器缓存这个结果并返回给浏览器
常见 DNS 记录类型:
- A 记录:将域名映射到 IPv4 地址
- AAAA 记录:将域名映射到 IPv6 地址
- CNAME:将域名映射到另一个域名
- MX 记录:指定该域名的邮件服务器
59. 服务器发送事件(Server-Sent Events,SSE)
服务器发送事件是一种让服务器通过单个长期 HTTP 连接向客户端持续推送更新事件流的方式。客户端只打开一次连接,服务器在有新内容时就持续发送事件。
客户端 -> 与服务器建立连接
服务器 -> 保持连接打开,并在事件发生时推送
底层原理:
服务器发送事件和 WebSockets 一样使用 HTTP 协议。服务器把响应内容类型设为 text/event-stream,然后保持连接打开,用浏览器原生理解的简单纯文本格式持续写入新事件。
60. 断路器(Circuit Breaker)
在微服务架构中,一个服务调用另一个已经失败或响应很慢的服务时,可能导致问题扩散,因为请求会堆积在等待一个已经挂掉的服务上。
示例:
- Order Service 调用 Payment Service。
- Payment Service 宕机,每次调用 30 秒后超时。
- Order Service 仍持续对每个新请求发起调用。
- 即使真正的问题在其他地方,Order Service 也被拖慢。
断路器如何解决?
断路器是服务调用外层的一个包装器,负责跟踪失败次数。一旦失败数超过阈值,它会在一定时间内完全停止调用该服务,而是快速失败。
状态:
- Closed(关闭):请求正常通过,失败被计数。
- Open(打开):错误数超过阈值,失败过多,所有请求被阻止。
- Half Open(半开):经过冷却期(打开后的等待时间)后,放少量请求过去,检查服务是否恢复。
典型工作流程:
Closed -> 失败超过阈值 -> Open -> 冷却期结束 -> Half Open -> 检查服务是否恢复健康
       -> 未恢复 -> Open
       -> 已恢复 -> Closed
至此,系统设计精要的 3 个部分已全部完成。我覆盖了学习系统设计所需的所有构建块。希望这对你有帮助。如果你觉得我遗漏了什么,请在评论中补充,我会为这个系列再写一部分。就到这里,祝你编码愉快!