
开发者实测Anthropic评估工具:还没看数据就让你写评估
Anthropic发布了Claude Code的新评估工具。其claude-api插件现在包含了一个新的build_eval和hill-climb命令,可以帮助你构建评估、检查评分器,并据此改进你的应用。
我通常不评论评估工具。软件变化太快,评论很快就会过时。但Anthropic的第一方工具很可能影响人们处理评估的方式,所以我想试试。
Isaac Flath和我一起直播了在公寓租赁助手的对话记录上使用它的过程。我们的发现如下:
不足之处
1. 它促使你在查看数据之前创建评估
Claude一开始就提出了几个潜在失败点,然后要求我们立即选择一个来转化为评估。它给了我们以下选项菜单,并推荐了通话转接规则。我们还没自己审阅对话,所以很难知道这是否是一个真正的失败,或者是否值得优先处理。尽管如此,我们还是按照推荐的选择进行了,因为我们觉得典型用户会这么做。
我认为你应该先查看数据,以便理解情况并确定哪些评估值得编写。代理可以帮助你发现问题,但你仍然应该先进行错误分析,以决定哪些失败值得关注。
2. 它要求你在没有足够上下文的情况下验证判断
接下来,Claude创建了Markdown文件,用于查看与通话转接失败相关的数据。在下面的截图中,Claude要求我们浏览inputs.md并“告诉它”哪些标签是错误的。这意味着在编辑器中阅读长对话,然后在聊天中单独报告更正。
我们发现这很愚蠢,因为我们在使用编码代理,所以它应该构建一个标注应用,让对话易于阅读,并允许我们在现场留下反馈。我们最终让Claude为我们构建了一个Web应用,并改用那个。
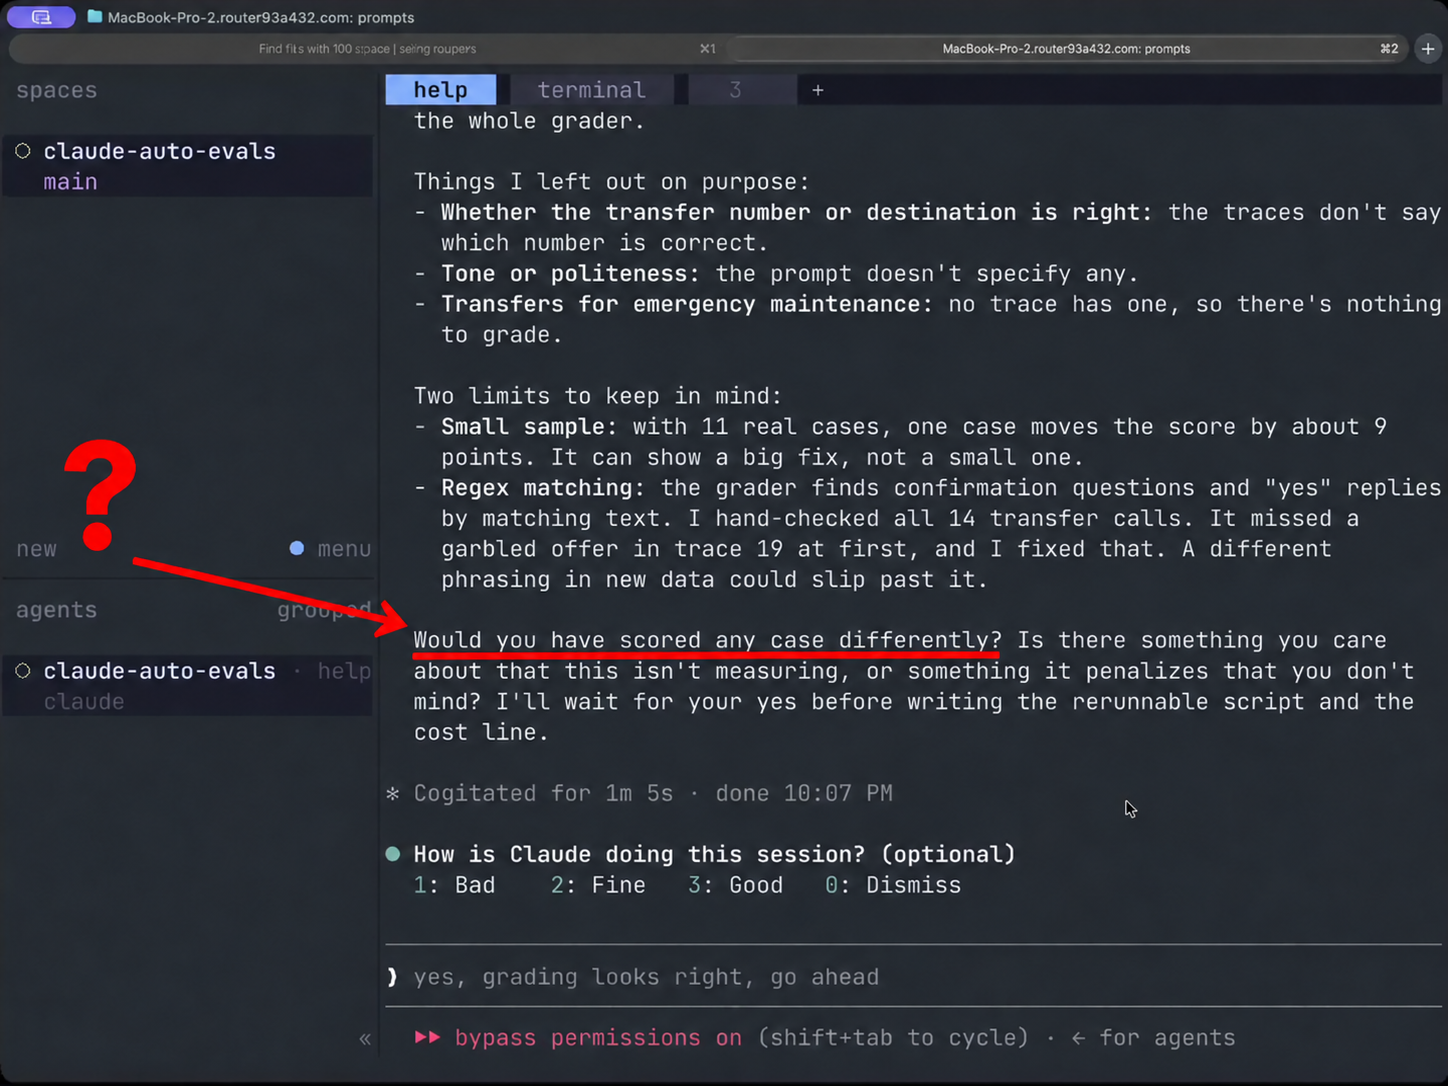
在工作流程的后期,Claude初次尝试为通话转接失败创建了一个评估器。它显示了聚合标签计数,并问我们“您会对任何案例给出不同评分吗?”,而没有给我们足够的信息来判断标签是否正确。工作流程中反复出现的主题是过快地创建工件或要求我们批准,而没有帮助我们理解数据。
3. 评估器的范围过于宽泛
接下来,该工具创建了一个通话转接评估器,同时检查了四个不同的失败点:
- 多次确认,或在未确认的情况下转接。(LLM作为评判)
- 在来电者同意和转接之间说了某些话。(基于代码的评估)
- 在转接期间或之后说了某些话。(基于代码的评估)
- 大声说出工具机制,比如“触发”转接。(基于代码的评估)
这个评估器捆绑了太多内容。我更倾向于将评估范围限定为一次只关注一个错误,或者至少将需要基于代码的评估和LLM作为评判的评估分开。
Claude对评估器的描述也令人困惑:
protocol_ok是主要指标。一个案例只有在所有四项检查都通过时才通过。在“不应转接”的调用中,如果没有发生转接,protocol_ok为1。
这种AI废话很难读。我更希望看到代码或评判提示,以便理解正在创建的内容。我发现阅读提示总是值得的,特别是对于像评估那样重要的东西。下面是工作流程这部分的样子截图:
优点方面
这个插件开箱即用地发现问题的能力给我留下了深刻印象,这是其他自动评估方法未能做到的!它发现了人工交接、格式化、语音代理等问题。仍然最好与代理迭代地查看数据,但这是我见过的“一次到位”问题发现方法中最强的表现。
Anthropic的博客文章介绍了这个工具,广泛传达了我同意的想法,例如查看数据的重要性、智能采样、不要使自己的评估饱和等。我很高兴更多人这样考虑评估。
我会使用它吗?
我暂时会等等。我希望工作流程能帮助我在提交评估器之前探索数据,并且从一开始就有更好的审查界面。此外,我已经很满意编码代理使用我和Shreya整理的这些评估技能所能做的事情,它们不那么固执己见(但更灵活)。
我之后和Claude评估插件的作者谈过。他对反馈表示感激,并说会相应更新插件,所以我预计它很快就会改变。将来可能值得重新审视。
即使这个插件发生了变化,我希望这个演练能帮助你评估其他评估工具。确保该工具帮助你在选择评估之前理解数据,并仔细检查其判断。我相信评估工作流程的大部分应该发生在Web应用中,而不是聊天中,以消除数据探索和标注的摩擦。
记住,如果一个评估工具没有把查看数据放在工作流程的中心,它就不值得使用。
感谢Isaac Flath审阅了这篇文章,并和我一起直播。