
谁来当评估员?Anthropic选了埃森哲,钱要自己掏
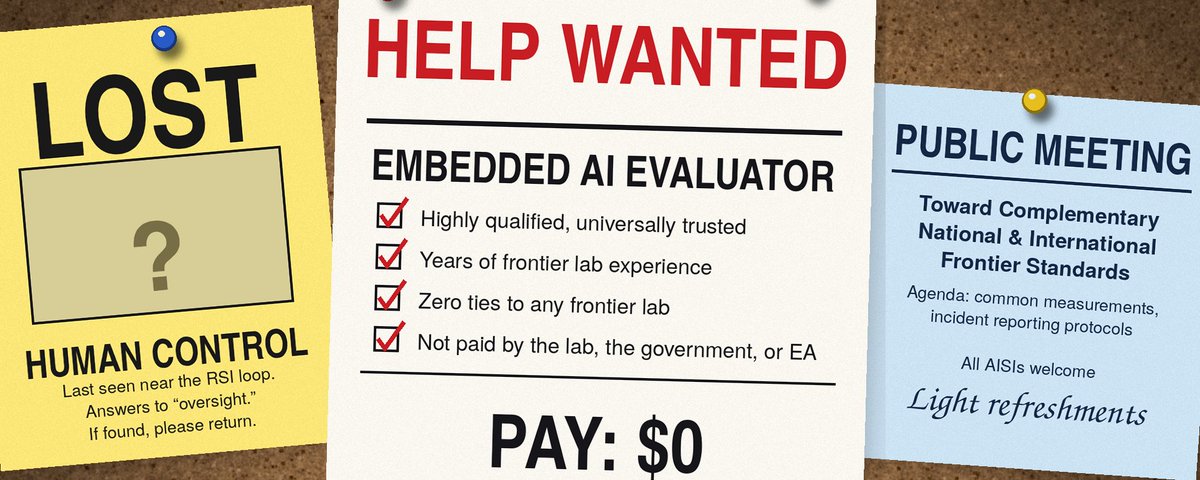
Dario Amodei在《我们必须为前沿定速》一文中,让Anthropic承诺采用嵌入评估员。评估员将被安置在Anthropic内部,获得员工级别的访问权限,好让他们能提供外部视角,并汇报正在发生的事情。
这里只有一个问题。谁来当评估员?
OpenAI也跟进做出了引入评估员的承诺,同时发出了一个不温不火但值得欢迎的呼吁,要求国际协调。这部分我也会在这里讨论。
今天不打算讨论、但希望明天能讨论的,是周末浮出水面的又一大批新的AI黑客攻击事件。这些事件凸显出我们急需嵌入评估员,而且很可能还需要远比这严厉得多的措施。
现在你只需要知道:还有不少OpenAI没有披露的事件,而OpenAI那边刚发生了一起新事件,迫使他们再次暂停了自己最先进的模型。我会马上去把这些梳理清楚。
听着,我只不过求你去找到一批足够合格、有经验、可信、没有利益冲突的嵌入评估员,他们完全免费干活,不要政府帮助,也不要实验室没有指定的EA来源的钱
你为什么告诉我这件事很难?
显然,标题中的这些要求无论单独看还是合起来看,都是可取的。它们都是锦上添花。问题是,在眼下条件下,你显然不可能同时凑齐所有这些要求。
总得有人在某个地方雇人,并付账。
那些合格、有经验、可信的人,必须以某种方式积累起这些经验和信任,而这必然涉及顶级实验室。
我不是说这些抱怨没有道理,但即使是成熟完善、高度受信任的审计计划,大多也缺乏好的解决方案。旋转门和资金来源都是难题。你仍得审计。
由Geoffrey Hinton、Stuart Russell和Arvind Narayanan领导的一群人,在一封公开信中列出了可信嵌入评估员的最低标准:
1. 前沿AI公司应依赖真正独立的评估员。
2. 报酬不能取决于发现的结果;不应存在所有权、治理或其他商业关系,也不应有编辑控制。任何利益冲突都应披露。
3. 前沿AI公司应纳入不同观点和专业领域。
4. 嵌入评估员应保持透明。
5. 嵌入评估员应受到保护,不受所嵌入公司的报复。
6. 前沿AI公司应给予嵌入评估员与其高权限员工同等的访问权限,数据保护所需的情况除外。
我同意。这看起来是一份不错的清单。
Gabriel Weil在7月指出,你不想让AI开发者自己雇佣裁判。但如果政府不想掏钱,而且整个氛围对这件事还相当敌视,那谁来挑选和雇佣他们呢?
我们活在愚蠢的时间线上。Weil担心政府将难以监督负责审计的IVO。他没想过,白宫可能会出于原则本身,主动对这些审计感到恼火。Weil的提议是强制责任保险。这倒是个好主意,尽管能完整发挥作用的版本根本买不到,而市场上卖出去的版本也覆盖不了我们最担心的那类事件。
如果Anthropic值2.2万亿美元,而我们还担心它可能“无法执行判决”,那到底谁才不是无法执行判决的?
我完全支持要求能力超过某个阈值的AI模型购买普通(或者说平平无奇的)保险,包括在内部部署或权重发布之前,而不仅仅是对外闭源部署之后。这会有一点用处。但它不会直接解决最重要的问题。
一种可能是,要求它们购买,就说1000亿美元或1万亿美元的保险吧,不是为了修复激励机制,而是因为这样一来,我们可以要求它们公布这份保险精确花了多少钱,并且要求保险公司披露它们定价时所用的相关风险因素。
Anthropic与埃森哲合作开展嵌入评估,还计划引入METR
他们宣布了与埃森哲的合作。
Anthropic:该合作将由埃森哲专门的AI业务部门Faculty牵头,内容包括评估和红队测试模型、开展对齐评估、测试模型安全措施。埃森哲帮助企业和政府跨多个行业部署AI。他们对AI在企业中实际应用方式的理解,为其安全策略提供了信息,届时他们也会把这种视角带到对我们模型的评估中。
Anthropic和埃森哲都预计在未来五年内各自投入至少10亿美元,建设这方面的能力。
……考虑到这项工作的重要性和紧迫性,Anthropic将直接资助埃森哲的工作。我们也在与METR和其他非营利评估机构对话,试点用它们自己的资金开展部分嵌入评估。最终,我们相信前沿AI需要一大批按共同标准运作的评估机构。
我们预计前沿实验室会同时与多个机构合作。我们的合作是非排他性的;Anthropic还会在接下来几周内公布与其他评估机构的合作,埃森哲也会以类似身份与其他AI开发者合作。
Charles:只要他们也允许METR参与,让埃森哲来干这个以满足对METR中立性的担忧,似乎完全没问题。
根据背景讨论和其他信息,加上这段文字的表面意思,我的理解是Anthropic计划两种方式结合使用。
自带资金和专业知识、能提供更多专家式内部视角并聚焦安全问题的非营利机构;
以及那种大型、正式、清晰可读的企业式路线,像治安法官一样从外部来看。
Drake Thomas提出了类似的逻辑:
Drake Thomas(Anthropic):AI公司接受那些对前沿对齐问题有着世界顶尖调查经验的深度专家团队的监督,是件好事。
AI公司接受那些无可指摘、无聊透顶且独立的来源的监督,也是件好事——即便是恶意的心理战行动也难从它们身上挑刺。
截至2026年9月,你还没法在同一个来源上把这两条轴都拉满,但没有任何东西阻止你拥有多个独立评估来源!我认为埃森哲和METR都处于选项的帕累托前沿上。显然,任何一家前沿AI公司,如果不把METR或Apollo这类组织深入纳入对其实践的评估,就没能充分做到向公众负责(至少在有更多拥有深厚AI审计人才储备的普通咨询顾问出现之前是这样;我希望这很快就会开始发生)。
而且我说帕累托前沿是认真的,我觉得很多人低估了埃森哲?比如,去翻翻埃森哲首席技术官兼Faculty首席执行官@MarcWarner10的推特,这些人可不是没听说过AI安全的人!
仔细想想,[上面这段话]有点太一边倒了,我想补充两点提醒:
(1) 提供资金显然会引入利益冲突,这是比如METR那种情况所没有的。
(2) 在某些方面,更多的监督来源是叠加的——多几次注意到问题并公开出来的机会当然很好——但也有代价:实验室可能会突出最友善的评估,或者拿它们来抵御外界更尖锐的批评。
我还有点担心,即使有一群非常好的天才在做这项工作时,在大型“正常”公司内部,也比较难说出非常直白、不寻常的批评,比如“这家公司现在正承担大量生存风险,应该立即停止”。
Scott Alexander:作为一个姓名决定论者,我支持你选一个姓“Warner”的人来做这份工作。
用埃森哲的明显问题包括:埃森哲和Anthropic之前就有过合作,而且这次行动由Anthropic出资。两者都不理想,但再说一次,还有别的选择吗?这项任务应当由Faculty分部来承担,如果它能保持自己的文化并保持独立,那是个合理的选择。他们在很多方面都清晰可信,也确实有一份过往记录。
Leo Gao(OpenAI):哦天哪,我确信埃森哲会有很多,呃,查了查笔记红队测试模型、评估对齐、测试安全措施的经验。毕竟他们网站上说,要拥抱变革的力量,为客户、员工、股东创造360度价值和共享成功——
Sy:说句公道话,Faculty在他们做的评估工作上确实有很强的专业能力。基本上所有重要的客户他们都合作过。
Anka Reuel:@Accenture如果能分享一份评估前沿模型的报告示例,会很有帮助。包括我在内的许多同事都担心他们是否具备足够的专业能力,因为我们还没有看到公开的例子来证明这一点。@MarcWarner10 @AnthropicAI
Luke Muehlhauser比较乐观,指出了一些参与的优秀人物。Oliver Habryka和Dave Kasten持怀疑态度。
如果非要我选一个评估员嵌入,我会选METR。
如果非要我选两个评估员嵌入,我会选METR,然后再选一个更清晰可读、更无聊的。选项并不好。
理论上,我在清晰可读这一档的第一选择是英国AISI,但有一些显而易见的原因,让它大概在白宫那边行不通。如果白宫支持并愿意出钱,CAISI理论上会很棒。然后你再看四大审计事务所,哪一家都没有这种专业能力,而且其中三家都像埃森哲一样是Claude商户。也许MITRE或RAND,但那里的资金情况又有各自的问题。没有太好的选项。
你也可能今天就去创办一家自己的审计公司,帮忙解决这个问题。
如何解读METR
Drake Thomas把过去这周关于嵌入第三方评估员的各种观点从最差到最好排了个序。我觉得这个分类学及其顺序是对的。
这类观点按数量看,绝大多数远低于零点,没有任何观点真正论证过“不,我们不应有嵌入评估员”。
过去这一周关于嵌入第三方评估员的各种观点,从最差到最好:
[对圈外毫无内容的嘲讽]
METR不好,因为[巨大的桑基图]。事实核查?梳理相对投资的时间线并看出因果关系?判断哪些数字是其他数字的大的还是小的分数?听着就像有效利他主义的鬼话。看看这张图,全是弯弯绕绕的线,你能看见一团蛇。
METR不好,因为[一条具体的行动者链条:每两个行动者之间都有某种成对关系,链条末端是某个如果与它们有强利益冲突会很糟糕的人,例如“METR曾从某个组织获得资助,该组织曾从某个人那里获得资助,而这个人曾资助过一家现在的前沿AI公司”]。解释这究竟如何影响METR的决策,有辱我的智商;你应该含糊地表演一种情绪站队,然后继续往下刷。别想太多。
哥们哥们哥们,你们必须把我的公司/组织嵌入实验室。自从七分钟前我看到这篇文章火起来,我就一直是外部嵌入审计的坚定支持者。看看我们以前发过的这个东西,你眯着眼睛看,它有点像是AI安全!别怕,我可以向你保证,我这辈子从没做过任何利他的事;就算做过了,我也一直做得毫无成效。
我观察到[政治化的行动者]有过[糟糕的观点]。让我用这个正确的观察为己方捞分,进一步政治化局势。
=== 零点:越过这条线的观点比下线强 ===
亲爱的[观点疯狂的人],这里诚恳解释一下你为什么错了。
METR不好/有问题,是因为[一个确实合理的担忧,比如与Anthropic的文化重叠度高于OpenAI,或者个别员工面临压力,要与实验室保持足够好的关系,以便日后可能被录用],但怎么处理这个问题,没有进一步建议。
有些推文同时承认(1)与实验室在社会上更独立一些会更好,(2)几乎所有有能力的人在社交上都与实验室有联系,即便他们没有提出解决办法。
[任何正面回应像METR、SecureBio、Guidelight、Redwood、Nightingale、Apollo等第三方组织对AI公司进行对象层面评估的观点]
=== 当前讨论前沿:越过这条线的观点比任何人已发布的都好 ===
我对METR/Redwood等机构有[确实合理的担忧]。为回应这个担忧,我们应该做[任何有道理并且能解决问题的具体提议]。
我正在创办一个新的第三方评估机构,/或者让我现有的机构转向做更多第三方评估。我们要做的内容是[既(1)不等于METR所做的事,也(2)对评估AI公司有些用处的事]。我们的初期工作将围绕[某个具体而有用的事情]展开。
METR存在X问题。我们应该改用已有的Y组织,Y没有X问题,而且在评估AI公司内部失控风险和错位事件上有同等专业能力,比如[它们过去做过的类似质量的工作]。(这会是绝妙的理解,但不可能发出来,因为没有这样的组织存在)
OpenAI建议做最省事的事
OpenAI就这个话题发表了一篇新文章,《为AI下一阶段建立标准》。他们强调,他们的目标仍然是一个自动化的AI研究员,到时会请它替我们做对齐作业,但前提是能安全地做到。
OpenAI:完全自主的RSI今天还不会发生,我们也不应该追求它,除非并且直到能够安全地做到。是否继续以及如何继续,必须取决于我们保持人类控制的能力,以及民众在充分知情的情况下对收益和风险做出的民主选择。
如果缺乏恰当的谨慎,RSI可能导致人类失去对AI发展的实际控制,无法对他们不再理解的研究过程进行监督。从这一点出发,AI可能变得更危险、更不对齐,总体而言对人类构成危险。
我们已经到了这一步:OpenAI说要“寻找让人类留在改进回路中的办法”,因为不这么做,这事就不会发生。
他们接着警告说,碎片化的国际标准或集体行动的缺失,可能导致糟糕的结果。没错。
OpenAI:我们主张制定标准,理由在于避免权力集中,并产生更好的实际结果。
这么多人都觉得有必要像念咒语一样反复念叨“避免权力集中”——这是你被允许去担心的东西。如果我们连这点都过不去,我看不出我们怎么走到一个好地方。
OpenAI:我们认为,美国应该牵头与世界各国合作,为前沿AI,包括RSI,制定全球技术标准。
好了,开场白够多了。提议是什么?
(1) 一种促进互补的国家和国际前沿标准的机制。
他们建议利用许多国家现有的AISI网络。
(2) 统一的测量方法和事件报告协议,以便更好地采取集体行动。
好吧,当然,这些总比什么都没有强,但这是一个非常温吞的提议。