
10个RAG项目:从基础PDF聊天到生产级AI系统
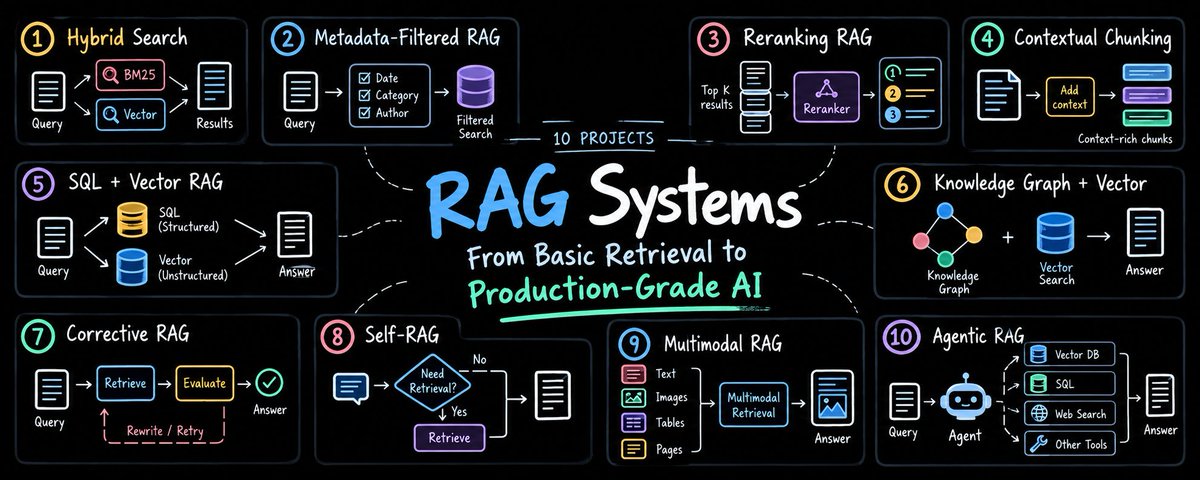
如果你正在学习RAG(检索增强生成),别再做另一个基础的“PDF聊天”应用了。基础RAG流程确实能帮你理解基础原理,但这只是开始,真实世界的RAG系统很快就会遇到更复杂的问题。
这些问题包括:语义搜索漏掉精确关键词怎么办?用户需要特定日期或类别的文档怎么办?召回的顶部片段实际上不是最有用的怎么办?答案需要同时用到结构化数据库数据和非结构化文档怎么办?检索本身失败了怎么办?系统需要处理表格、图像或多个知识源时会发生什么?
如果你想从基础RAG进阶到生产级AI系统,以下是推荐完成的10个项目:
1. 混合搜索RAG
问题:向量搜索擅长理解语义相似性,但有时候精确词语更重要。搜索特定错误代码、产品ID、API名称或技术术语时,关键词搜索比纯语义检索效果更好。
项目内容:结合BM25关键词搜索与密集向量检索,系统用两种方法检索文档并合并结果,得到更好的候选集。
技术栈:Python、BM25、Elasticsearch/FAISS、Sentence Transformers
学到内容:词汇检索和语义检索如何互补,为什么生产级搜索系统通常需要不止一种检索策略。
2. 元数据过滤RAG
问题:仅靠语义相似性并不够用。比如用户提问“2026年认证服务做了哪些变更?”,你不需要搜索知识库中的所有文档,而是需要先把检索限制在相关元数据范围内。
项目内容:将语义搜索与日期、类别、作者、部门、位置、文档类型等过滤器结合。
技术栈:Python、PostgreSQL、pgvector、Pydantic、OpenAI
学到内容:结构化过滤和语义检索如何配合工作。
3. 重排序RAG
问题:向量数据库可能返回20个看起来相关的片段,但相关性不是二元的,部分片段会比其他片段优质得多。
项目内容:先召回更大规模的候选集,再用重排序器给候选打分,只把质量最高的结果发给大语言模型。
技术栈:Python、FAISS/pgvector、CrossEncoder/Cohere Rerank、OpenAI
学到内容:检索和排序的区别,为什么提升检索质量不一定要更换嵌入模型。
4. 上下文分块RAG
问题:传统分块会破坏上下文。比如一份文档包含认证服务的所有者、区域、版本信息,你只召回了包含“版本:3.2”的片段,嵌入能用到的上下文非常少。
项目内容:在嵌入之前,给单个分块添加文档级的相关上下文。
技术栈:Python、Docling、OpenAI/Claude、pgvector
学到内容:为什么分块本身就是一个检索问题,不只是文本处理问题。
5. SQL+向量RAG
问题:不是所有问题都适合放在向量数据库里。比如提问“上个月有多少客户升级到专业版,这些客户最常见的投诉是什么?”,前半部分需要结构化数据,后半部分可能需要对客服对话做语义搜索。
项目内容:将SQL查询和向量检索结合。
技术栈:Python、PostgreSQL、pgvector、SQLAlchemy、LangGraph
学到内容:如何判断一个问题应该通过结构化查询回答,还是语义检索回答,或是需要两者结合。
6. 知识图谱+向量RAG
问题:向量搜索擅长找到相似信息,但相似不等于有关系。比如提问“如果支付服务宕机会影响哪些服务?”,答案可能依赖服务之间的明确关系。
项目内容:将向量搜索和知识图谱结合。
技术栈:Python、Neo4j、pgvector、OpenAI、LangGraph
学到内容:什么时候语义相似性就足够,什么时候实体之间的明确关系能带来额外价值。
7. 校正RAG
问题:大多数基础RAG流程都默认检索成功,召回一些文档后直接传给大语言模型。但如果召回的上下文不相关怎么办?生产系统需要识别检索失败。
项目内容:生成最终答案前先评估召回的上下文,如果结果质量差,系统可以重写查询、重新检索、搜索其他来源、优化上下文,或是拒绝回答。
技术栈:Python、LangGraph、OpenAI、pgvector、Tavily
学到内容:如何给检索构建反馈循环,而不是把检索当成一定会成功的操作。
8. 自检索RAG
问题:大语言模型需要给每个问题都检索信息吗?未必。如果有人问“Python是什么”,可能没必要搜索知识库;但如果问“我们公司最新的事件响应政策是什么”,检索就必不可少。
项目内容:构建一个能判断何时需要检索、评估检索到的证据、并验证答案是否有足够支撑的系统。
技术栈:Python、LangGraph、OpenAI、pgvector
学到内容:检索如何成为推理过程的动态部分,而不是必须的第一步。
9. 多模态RAG
问题:现实中的文档不只有文字,还包含表格、图像、图表、截图、示意图、扫描页。把所有内容都转成纯文本会丢失宝贵信息。
项目内容:构建能够对多种模态做检索和推理的RAG系统。
技术栈:Python、Docling、多模态大语言模型、向量数据库、OpenAI
学到内容:当检索流程需要保留不止文字的内容时,文档理解会发生什么变化。
10. 智能体RAG
问题:有时候一次检索不够,一个问题可能需要多个来源的信息。比如提问“对比我们当前的架构和两年前的架构,找出发生变更的服务”,这可能需要搜索文档、查询结构化数据、梳理多个实体之间的关系。
项目内容:构建一个能自主判断:查询哪个来源、使用哪个工具、是否需要再检索一次、什么时候信息足够、如何合并结果的智能体。
技术栈:Python、LangGraph、OpenAI、向量数据库、搜索API
学到内容:RAG如何从固定流程演进为能动态选择检索策略的系统。
从整体来看
这10个项目并不是完全独立的架构,你可以把它们组合起来。一个生产级RAG系统最终可以根据问题需求,组合加入SQL、知识图谱、多模态检索、外部搜索或智能体编排。
从“我做了一个RAG聊天机器人”到“我做了一个生产级RAG”,不是靠简单换个向量数据库就能实现,而是要学会让检索变得准确、有上下文、经过过滤、排序、可验证、自适应。如果你真的想认真构建AI应用,这些项目很适合加入你的RAG学习路线。